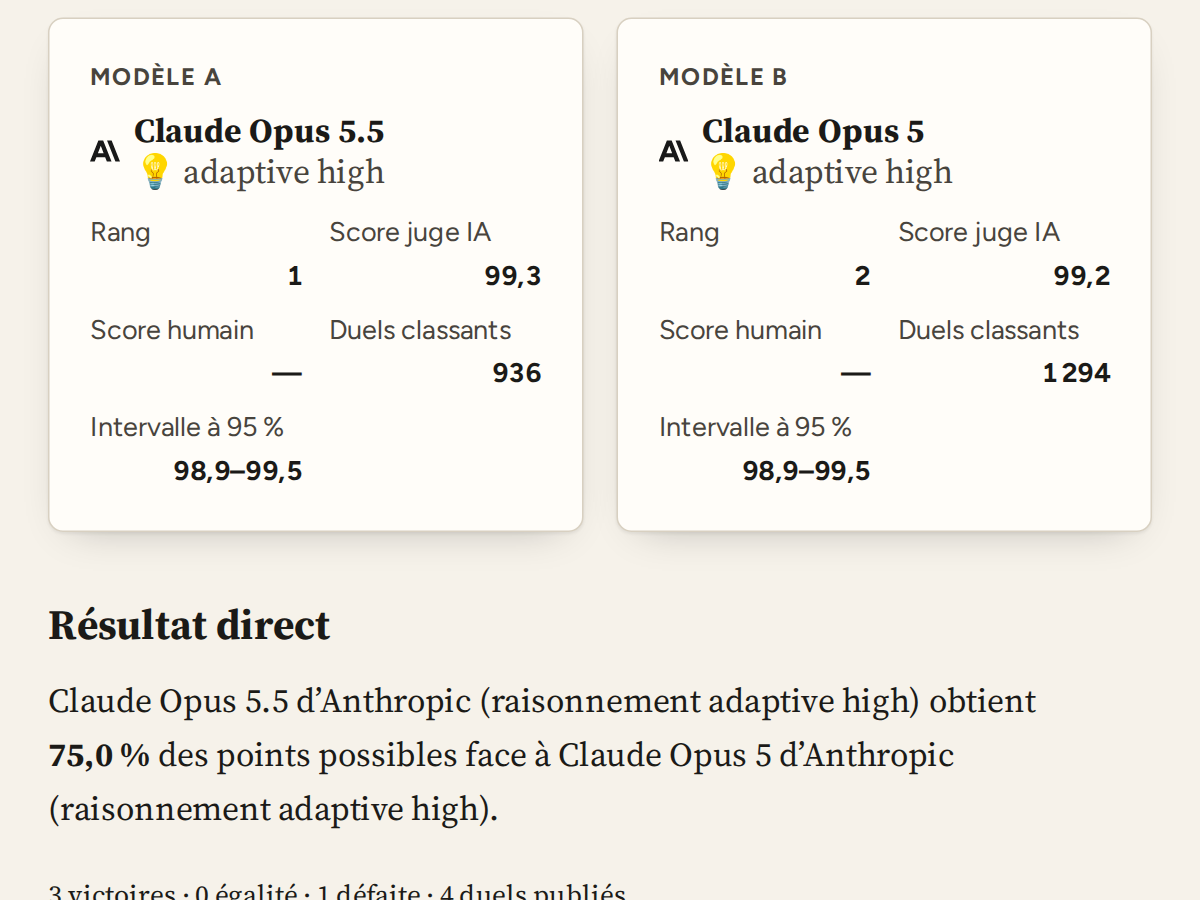
Claude Opus 5.5 d’Anthropic (raisonnement adaptive high) est aujourd’hui le modèle qui écrit le mieux en français, avec un score de 98,3. Parmi les modèles qu’on peut faire tourner sur sa propre machine, Qwen3.8 27B d’Alibaba (Q4_K_M, raisonnement xhigh) est en tête avec 71,9.
Le Baromètre mesure la qualité d’écriture des principaux modèles d’IA à partir d’un corpus de consignes conçu directement en français. Les réponses à une même consigne sont comparées à l’aveugle, sans le nom des modèles, puis les verdicts sont agrégés dans un classement propre au français.
106 modèles comparés sur 105 456 verdicts à l’aveugle, actualisé le 13 octobre 2026.
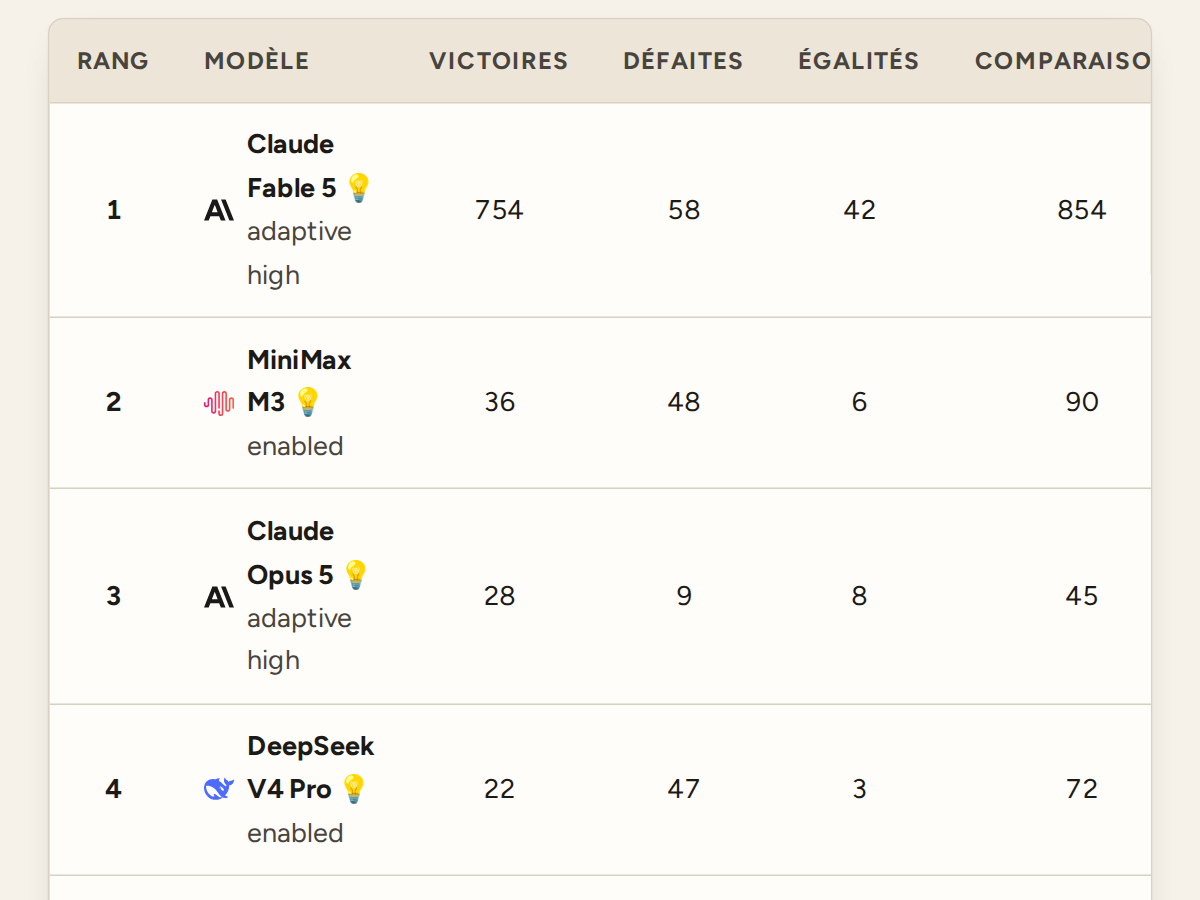
Les 10 meilleurs modèles
Les dix meilleurs modèles pour écrire en français
#
Modèle
Score
1
Claude Opus 5 💡 adaptive high
99,2
2
Claude Opus 5.5 💡 adaptive high
98,3
3
GPT-6.1 Sol 💡 high
97,8
4
Claude Fable 5.1 💡 adaptive high
97,7
5
Claude Fable 5 💡 adaptive high
96,8
6
Claude Sonnet 5.5 💡 adaptive high
96,7
7
Claude Opus 4.8 💡 adaptive high
96,1
8
GPT-6 Sol 💡 high
95,9
9
GPT-6 Astra 💡 high
95,5
10
Kimi K3 💡 enabled
94,0
Ce score n’est pas une note en pourcentage : 50 correspond à une chance estimée sur deux de battre le modèle moyen en français.
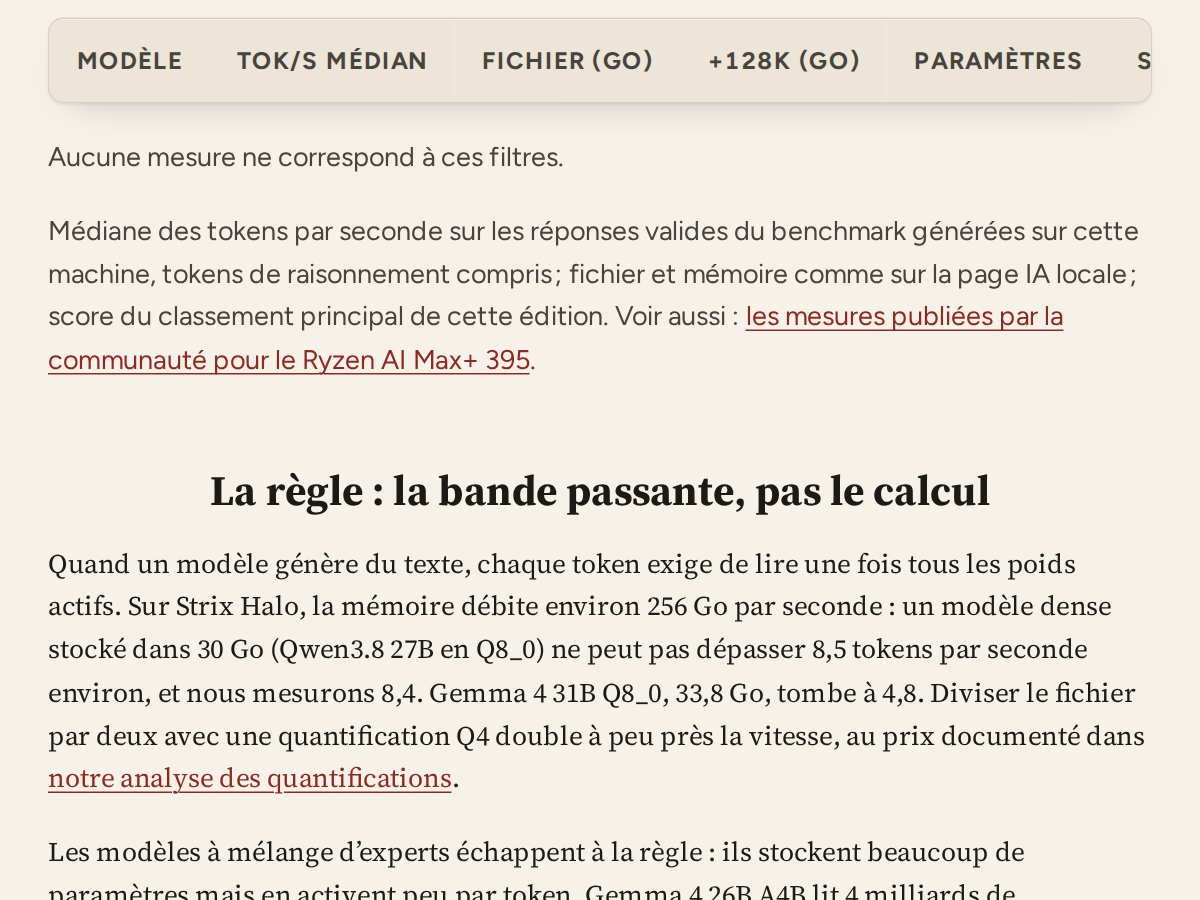
Taille du fichier GGUF testé (Go décimaux, comme dans LM Studio) · +128K : Fichier + cache de contexte à 131 072 tokens (128K), cache F16, Flash Attention active (Go) · +256K : La même chose à 262 144 tokens (256K), limité au contexte natif (Go)
Le meilleur modèle local selon votre mémoire
La variante qui écrit le mieux parmi celles qui tiennent dans la mémoire de la carte graphique ou la mémoire unifiée, contexte court. Détails, vitesses et alternatives sur la page IA locale.
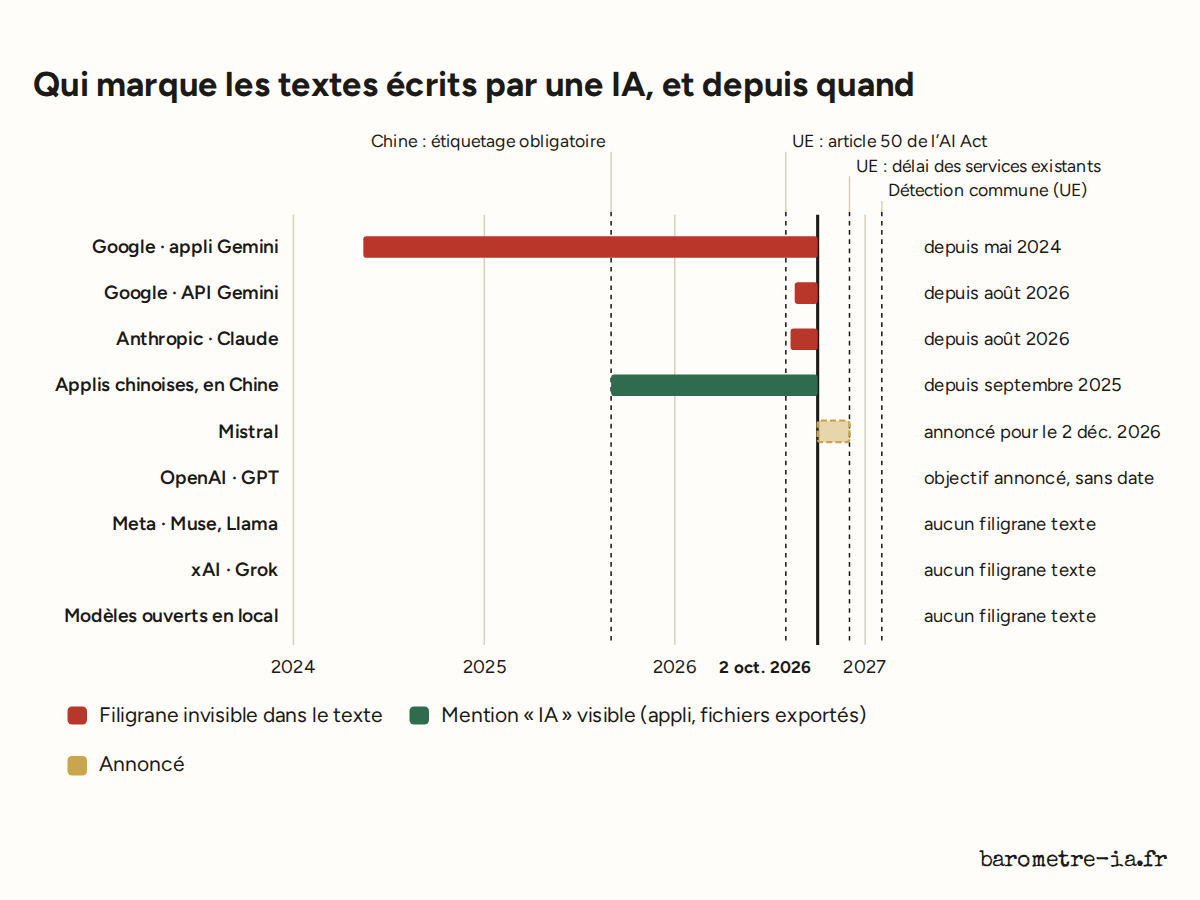
Depuis cet été, les textes de Claude et de Gemini portent une marque invisible. Ceux de ChatGPT, Grok, Mistral, Meta AI et des modèles installés sur son ordinateur n’en portent aucune, et les services chinois se contentent d’une mention visible. Mais personne, hors des entreprises concernées, ne peut aujourd’hui vérifier un texte.
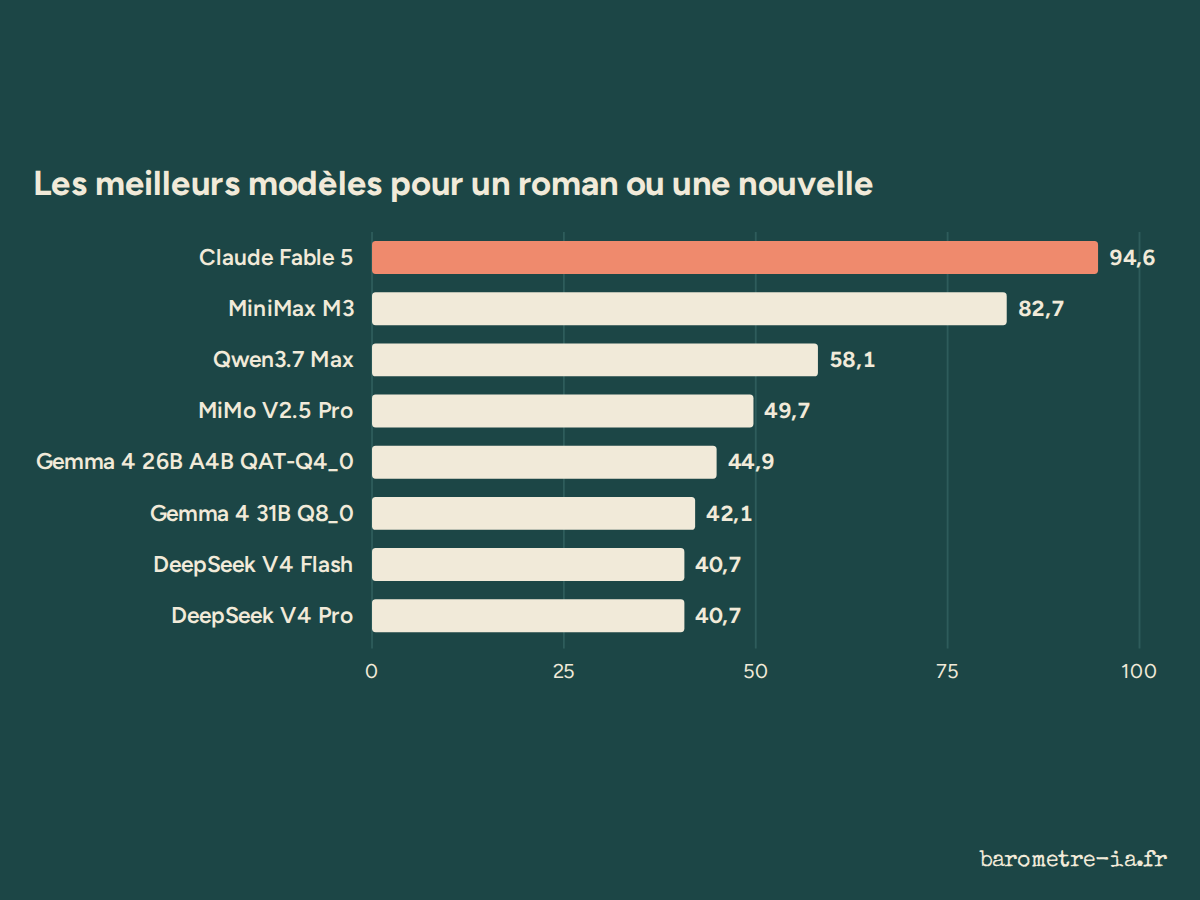
Le classement a un vainqueur ; vos textes n’en ont pas un seul. Au 20 septembre, sur les seuls duels d’un type de texte, Claude Fable 5 dominait la fiction et la dissertation, Claude Opus 5 les lettres personnelles, Claude Fable 5.1 les lettres de motivation. Un guide simple, tâche par tâche, avec le meilleur fichier à faire tourner chez soi pour chacune.
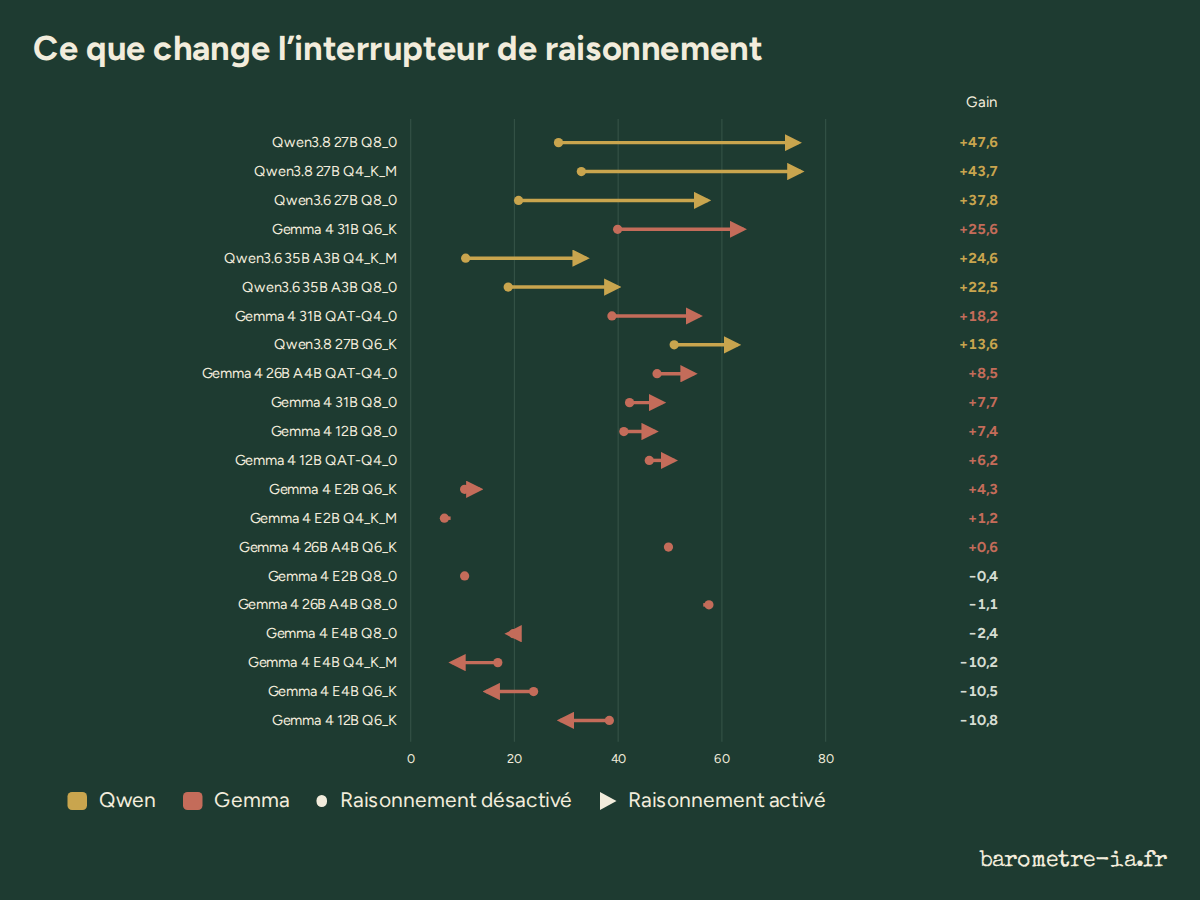
Même fichier, mêmes consignes, un seul interrupteur. Sur 21 versions locales, activer le raisonnement rapporte en moyenne 32 points à la famille Qwen et 7 aux Gemma 4 de 12B et plus ; les petits Gemma E2B et E4B y perdent 3 points en moyenne. Qwen3.8 27B Q8_0 gagne 48 points, plus que tout autre modèle en français.
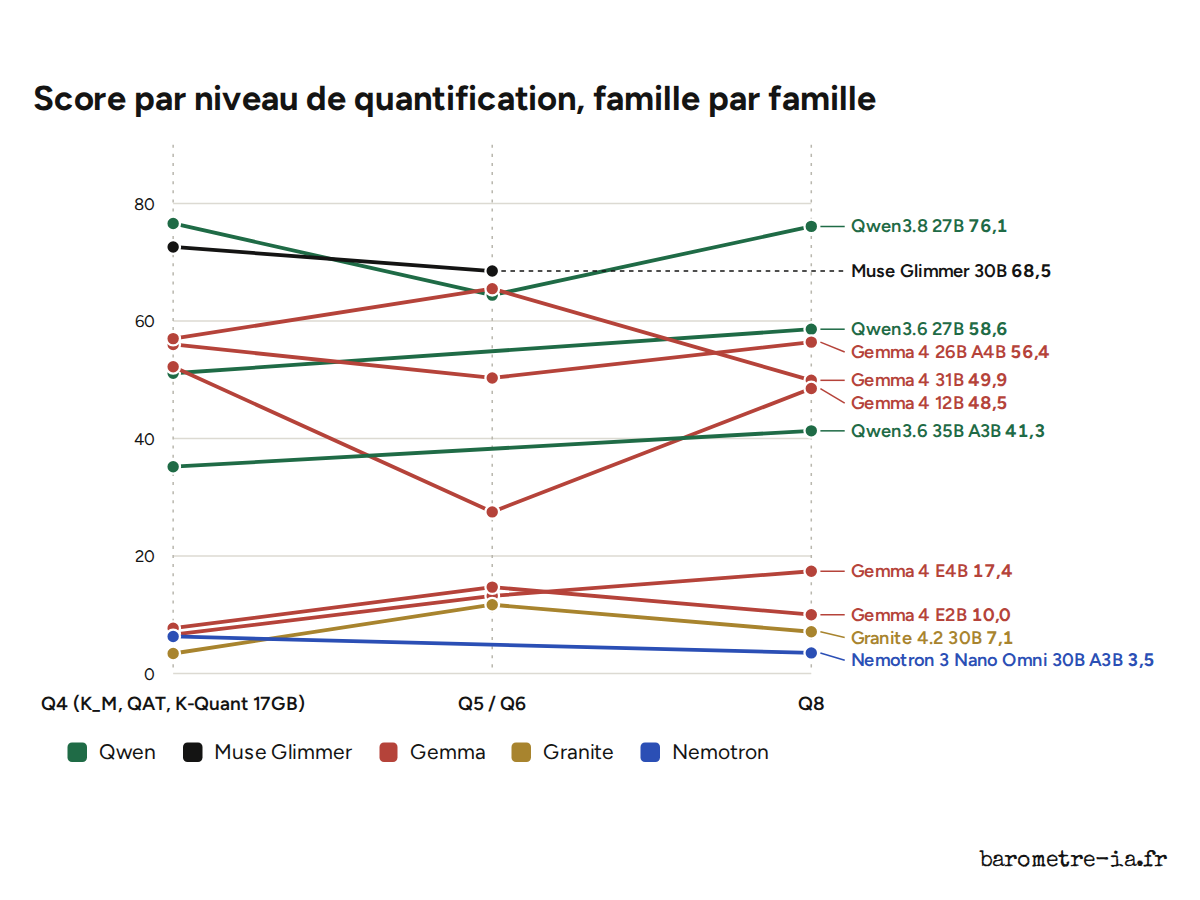
Même modèle, trois fichiers, trois scores. En français, Qwen3.8 27B écrit aussi bien en Q4_K_M qu’en Q8_0 avec un fichier deux fois plus petit, mais sa version Q6_K perd douze points. Gemma 4 31B fait mieux en Q6 qu’en Q8. Gemma 4 12B s’effondre en Q6 et tient en Q4. Il n’y a pas de règle générale, seulement des mesures.
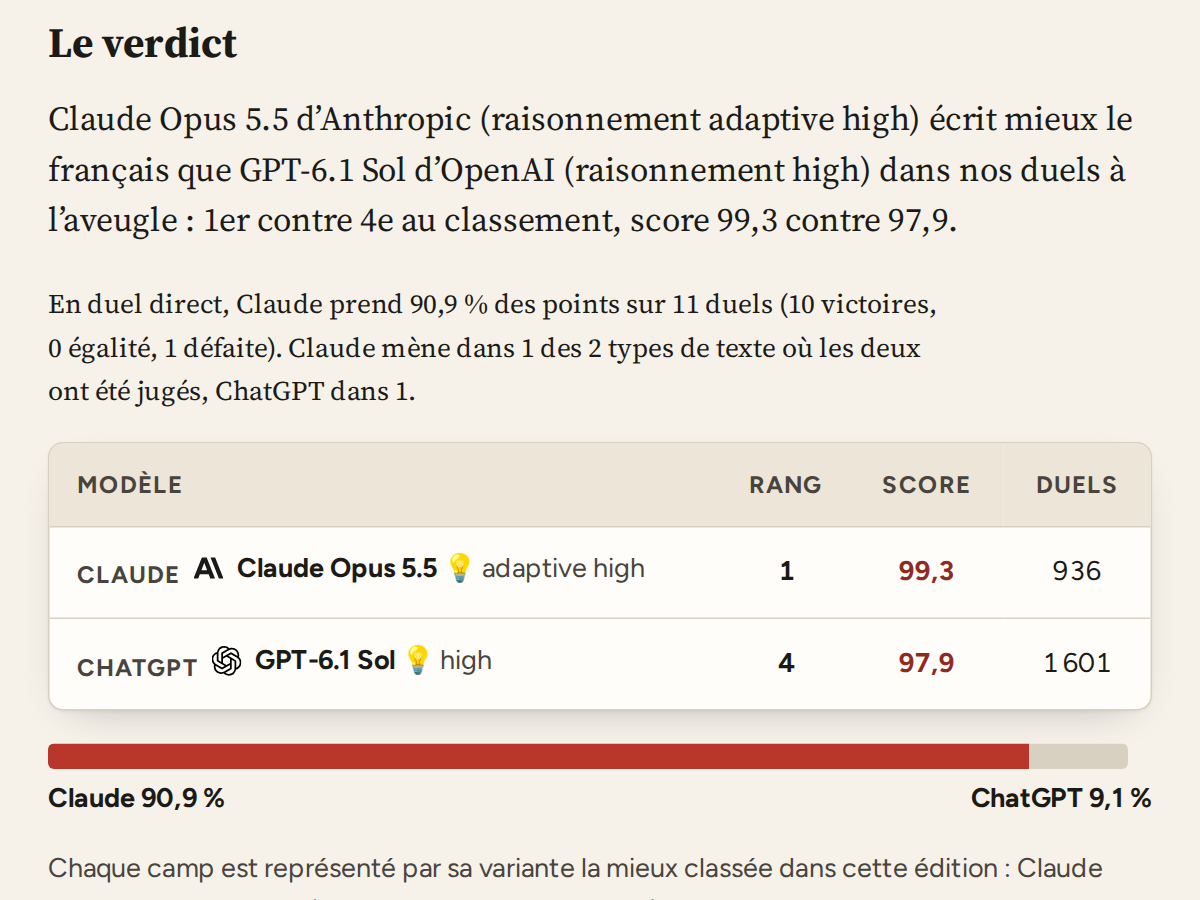
Les deux assistants les plus demandés, jugés sur les mêmes consignes en français dans des duels à l’aveugle : lequel écrit le mieux, de combien, et pour quels types de texte. Mis à jour à chaque export du classement.
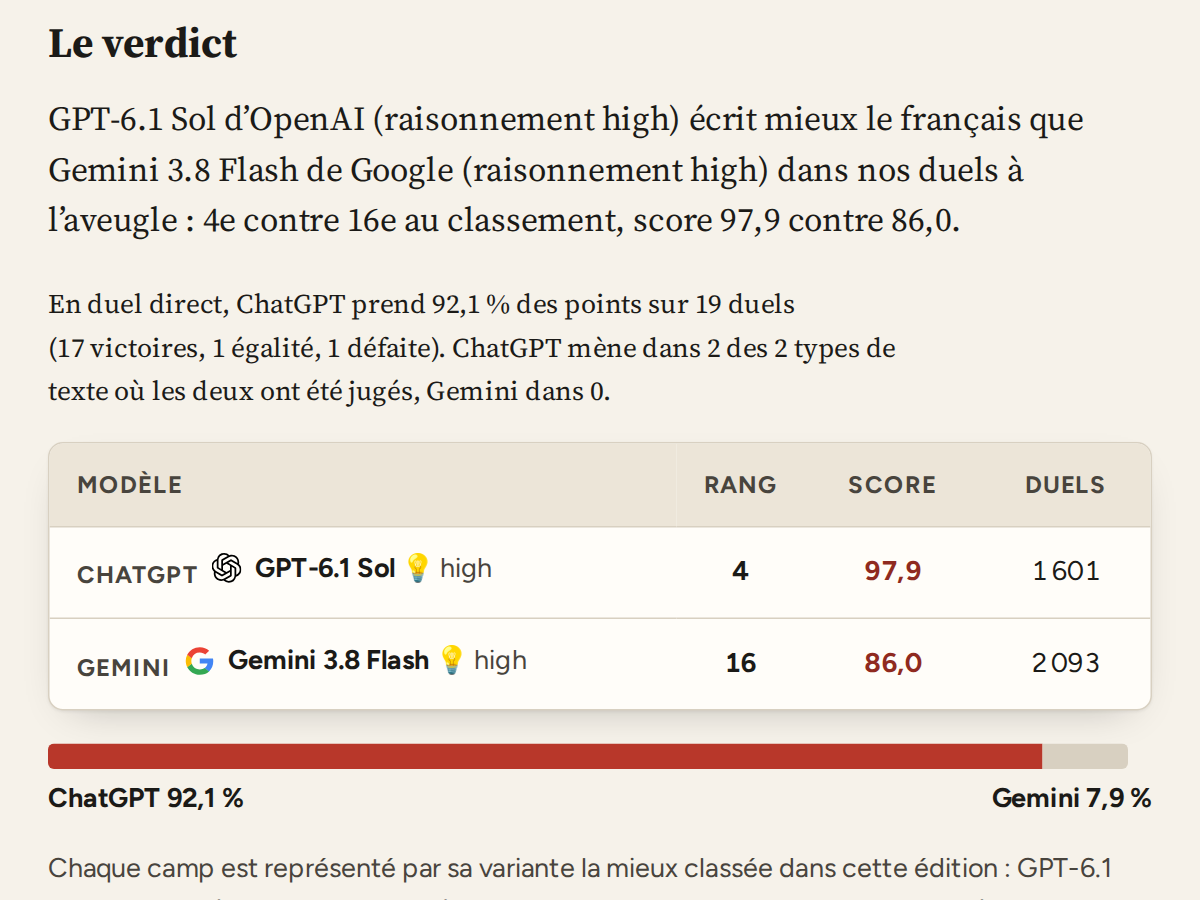
Le meilleur modèle d’OpenAI contre le meilleur de Google, sur les mêmes consignes en français, en duels à l’aveugle : qui mène au classement, comment se sont passés les duels directs, et où chacun est le plus fort.
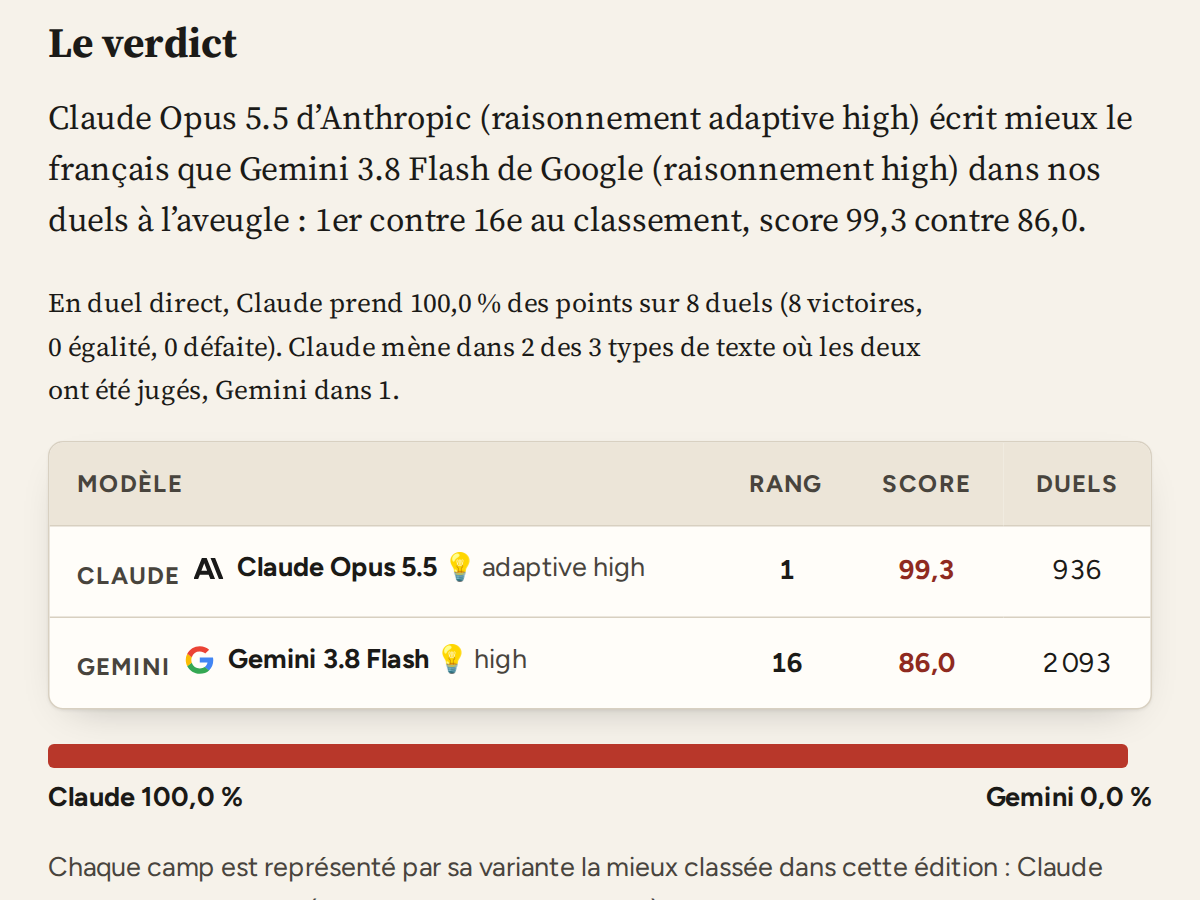
Le meilleur modèle d’Anthropic contre le meilleur de Google, sur les mêmes consignes en français, en duels à l’aveugle : l’écart au classement, le bilan direct, et les types de texte où Gemini s’approche le plus.
Qui tient ce baromètre, sur quelles machines, et les principes derrière les duels à l’aveugle.
Le classement porte uniquement sur la qualité d’écriture. Les consignes sont conçues dans la langue évaluée et les noms des modèles restent masqués jusqu’au verdict, afin que leur réputation n’influence pas l’évaluation. Ce site est un projet personnel. Je ne suis payé par aucun éditeur de modèles et je n’ai aucun intérêt à en favoriser un.