

Quelle IA locale choisir ?
La meilleure IA locale pour écrire en français, selon nos comparaisons en aveugle, est la variante placée en tête du tableau ci-dessus.
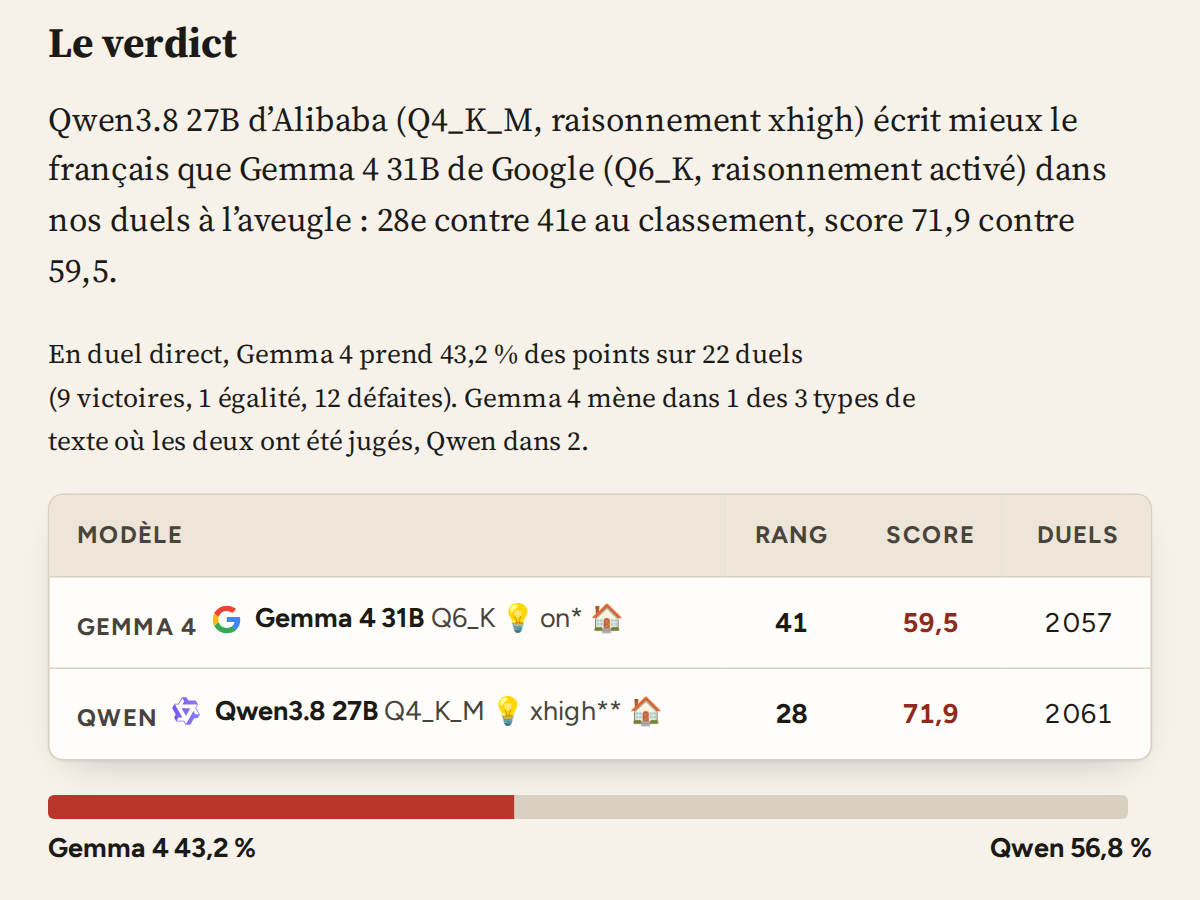
Qwen3.8 27B d’Alibaba (Q4_K_M, raisonnement xhigh) est la meilleure variante locale de la sélection active, avec un score de 71,2. Elle demande 26,5 Go avec un contexte de 128K.
Ce qui compte comme « local » ici
Quatre conditions, appliquées sans exception :
- Des poids ouverts. Les fichiers du modèle sont téléchargeables publiquement et utilisables en dehors de l’infrastructure de l’éditeur.
- Une exécution réellement hors ligne. Une API fermée au nom engageant ne suffit pas.
- Moins de 256 milliards de paramètres au total. Strictement sous ce seuil.
- Une évaluation déjà faite sur ce site. Pas d’estimation ni de ligne provisoire dans le classement.
Le seuil porte sur le nombre total de paramètres, y compris pour les modèles à mélange d’experts. L’erreur est fréquente et lourde de conséquences : un modèle MoE qui n’active qu’une petite partie de ses paramètres à chaque token doit tout de même garder tous ses poids en mémoire. Le total décide de l’admission et de la mémoire nécessaire ; les paramètres actifs jouent sur la vitesse. Quand les deux sont connus, le nom du modèle les garde tous les deux (par exemple 35B A3B), pour que le nombre actif renseigne sur la vitesse sans être pris pour un chiffre de mémoire.
Les critères n’exigent pas que les réponses aient été générées chez nous. Un modèle est admissible parce que ses poids sont disponibles et qu’il peut tourner en local, pas en raison du lieu où ses textes ont été produits pendant nos campagnes. Quand la vitesse d’une variante a été mesurée sur notre propre machine, le chiffre est présenté comme une mesure du Baromètre.
D’où viennent ces scores
Le Baromètre compare des textes deux à deux, en aveugle, sur des consignes rédigées nativement en français. Les scores affichés ici sont exactement ceux du classement général français : nous ne recalculons pas un classement isolé entre modèles locaux, nous filtrons le classement existant pour ne garder que les variantes exécutables localement, puis nous renumérotons les rangs.
Cela signifie qu’une variante locale a pu être comparée à des modèles cloud, et que ces duels comptent dans son score. C’est volontaire, pour deux raisons simples : l’échelle reste commune entre toutes les pages du site, et chaque modèle conserve davantage de données derrière son score. Le rang, lui, est bien un rang local : le numéro 1 de cette page est le meilleur modèle exécutable chez vous, pas le meilleur modèle tous accès confondus.
Précision utile : ces scores mesurent la qualité d’écriture en français, jugée sur des textes consultables. Ce n’est pas un classement d’intelligence générale, ni un indicateur de performance en code ou en mathématiques. Un modèle excellent ici peut être médiocre ailleurs, et l’inverse est vrai aussi. Précisons également qu’un modèle conçu en France ou en Europe n’écrit pas mieux en français par principe : cela se mesure, et parfois le résultat surprend.
Qu’est-ce que la quantification, concrètement
Un modèle est un très grand ensemble de nombres. La quantification consiste à stocker ces nombres avec moins de bits : au lieu de seize bits par poids, huit, six ou quatre. Le fichier rétrécit, l’empreinte mémoire aussi. Sur une inférence limitée par la bande passante mémoire — ce qui est le cas courant en génération de texte sur une machine personnelle — lire moins d’octets à chaque token peut également accélérer la génération.
Le compromis est qu’on perd de l’information. Une quantification peut modifier la qualité du texte, et l’ampleur de cet effet dépend du modèle, de la méthode employée, de la tâche, de la langue, de la longueur du contexte et du niveau de compression. C’est pourquoi nous ne reprendrons jamais à notre compte les formules du type « la Q4 conserve 98 % de la qualité » : ce chiffre n’existe pas de façon universelle, et il est particulièrement fragile pour l’écriture dans une langue autre que l’anglais.
Les formats que vous verrez ici :
- Q8 — huit bits. Nous la traitons comme notre référence pratique de haute qualité. Cela ne veut pas dire qu’elle est mathématiquement identique au modèle d’origine en BF16 ou FP16, ni que l’écart est toujours imperceptible : cela se mesure modèle par modèle.
- Q4 QAT — un modèle préparé ou entraîné en tenant compte d’une exécution en quatre bits (quantization-aware training). Ce n’est pas une compression appliquée après coup : c’est un checkpoint distinct, publié comme tel par son éditeur.
- Q4_K_M — une quantification GGUF appliquée après l’entraînement, à quatre bits, avec des précisions mixtes selon les couches. C’est un bon format, mais ce n’est pas du QAT, et il ne faut pas confondre les deux dans un tableau.
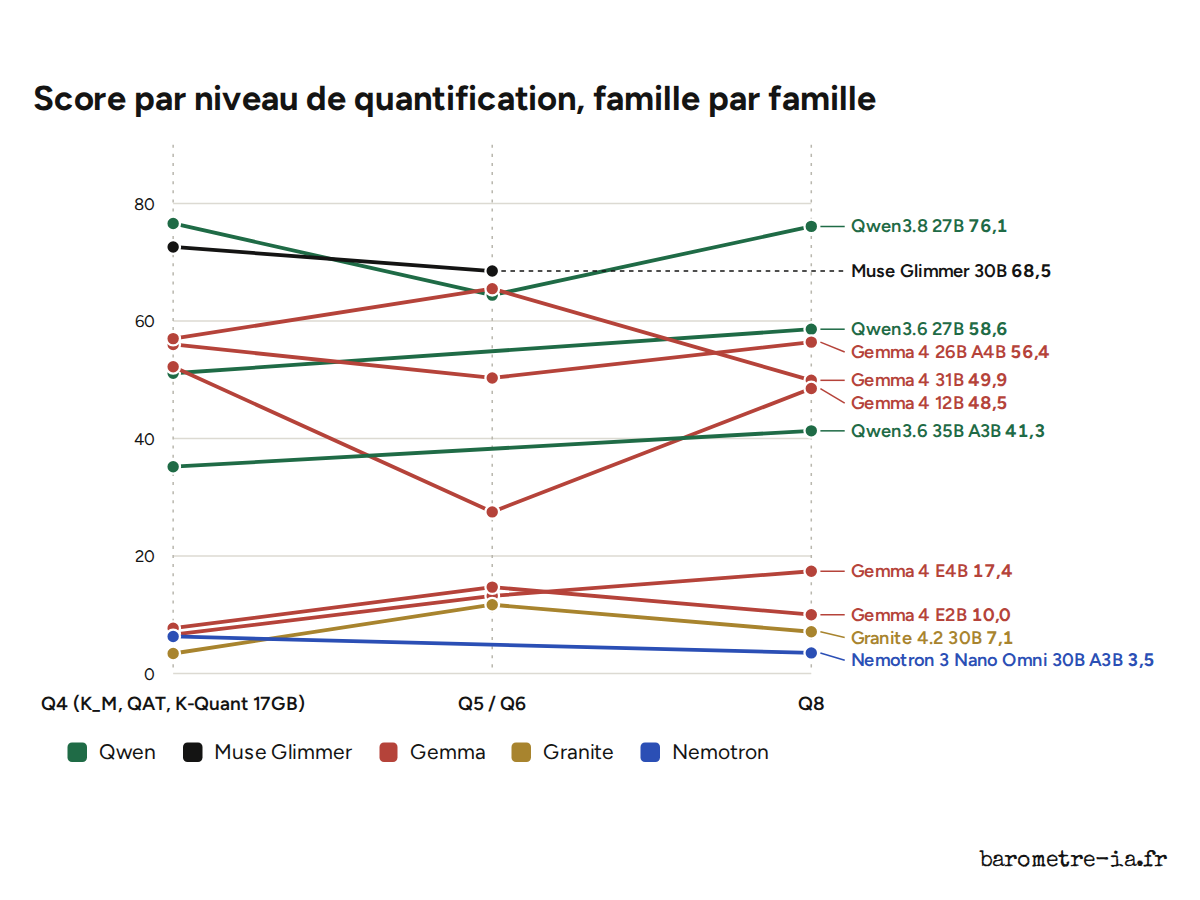
- Q6 — un compromis intermédiaire entre Q4 et Q8, désormais évalué sur plusieurs familles et affiché par défaut. Il n’est pas toujours meilleur que le Q4 : notre analyse des quantifications montre où il gagne et où il perd.
Les deux K-Quant de Muse Glimmer
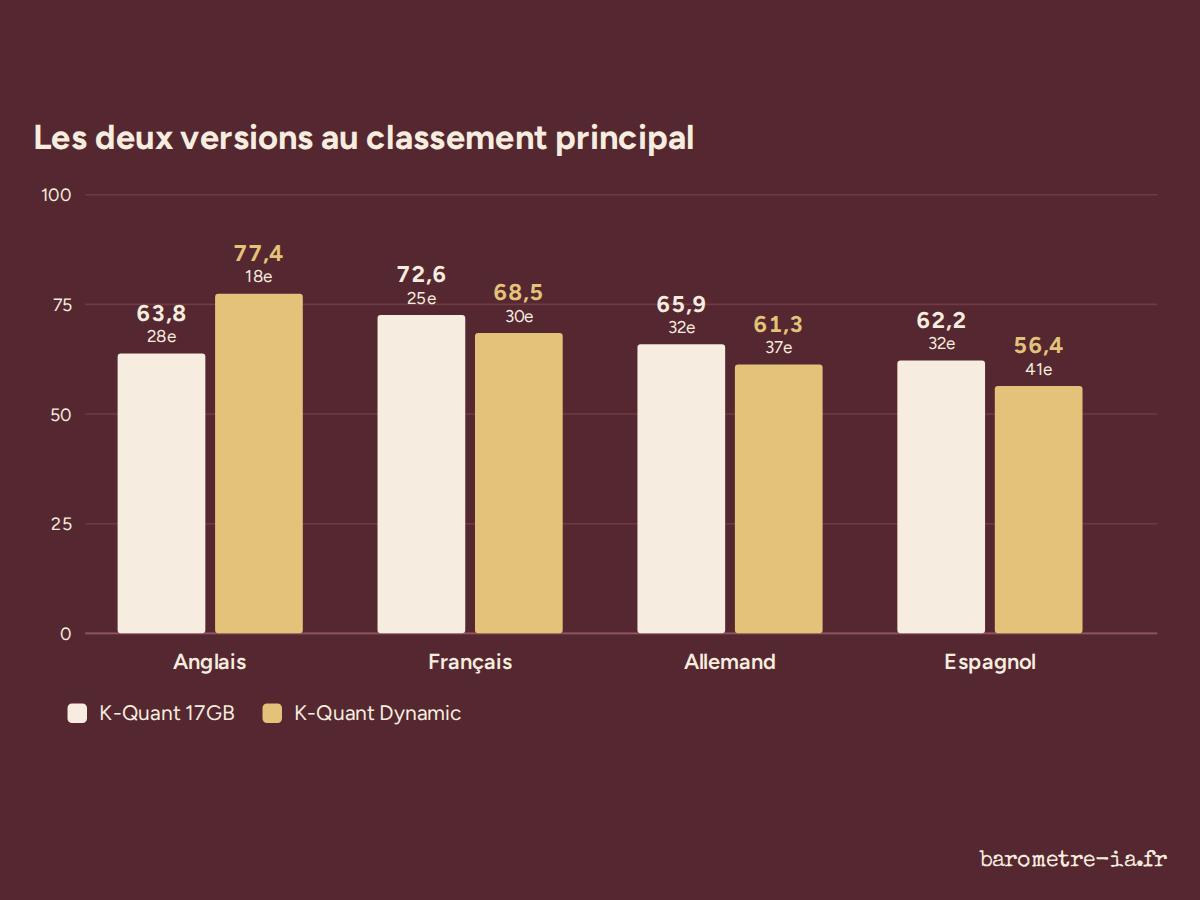
Meta publie Muse Glimmer 30B dans deux fichiers GGUF inhabituels, entre quatre et cinq bits par poids en moyenne. K-Quant Dynamic conserve certains tenseurs avec une précision supérieure et vise 32 Go de VRAM ; K-Quant 17GB compresse davantage et vise 24 Go. Ce ne sont pas des fichiers Q4_K_M : nous gardons donc leurs noms exacts et les évaluons comme deux variantes distinctes. Dans les filtres, K-Quant 17GB figure sous « ≈ Q4 (K-Quant) » et K-Quant Dynamic sous « ≈ Q5 (K-Quant Dynamic) » : ces étiquettes indiquent une classe de précision approchée, sans prétendre que l’encodage est celui d’un Q4_K_M ou d’un Q5_K_M.
Meta annonce une dégradation moyenne respective de 0,2 % et 1,0 % sur quinze benchmarks courants. Il s’agit de mesures de l’éditeur, et non de scores d’écriture AIWB ni de garanties pour la prose française, anglaise, allemande ou espagnole. Nos classements et notre comparaison directe mesurent séparément les deux fichiers sur des consignes rédigées nativement.
Recommandations par machine
La question qu’on nous pose le plus n’est pas « quel modèle écrit le mieux » mais « quel modèle écrit le mieux sur ma machine ». Cette échelle y répond pour les tailles de mémoire courantes, de la carte graphique de 8 Go à la station de travail avec 128 Go de mémoire unifiée. Chaque palier nomme la variante qui écrit le mieux parmi celles qui tiennent, et la variante la plus rapide que nous ayons mesurée qui tient aussi. Les paliers où rien ne change sont fusionnés.
8 Go
RTX 4060 · RTX 5060 · RX 7600
Meilleure qualité
 Gemma 4 E2B 💡 🏠
Alternative plus rapide mesurée
Gemma 4 E2B 💡 🏠
12–16 Go
12 Go : RTX 3060 12 Go · RTX 4070 · RTX 507016 Go : RTX 4060 Ti 16 Go · RTX 5070 Ti · RTX 5080 · RX 9070 XT · Mac avec 24 Go de mémoire unifiée
Meilleure qualité
Gemma 4 12B 💡 🏠
Alternative plus rapide mesurée
Gemma 4 E2B 💡 🏠
24 Go
RTX 3090 · RTX 4090 · RX 7900 XTX · Mac avec 32 Go
Meilleure qualité
 Qwen3.8 27B 💡 🏠
Alternative plus rapide mesurée
Gemma 4 E2B 💡 🏠
32–128 Go
32 Go : RTX 5090 · Mac avec 48 Go48 Go : RTX 6000 Ada · deux cartes de 24 Go · Mac avec 64 Go · Strix Halo 64 Go64 Go : Mac avec 96 Go96 Go : RTX PRO 6000 · Mac avec 128 Go · DGX Spark · Strix Halo 128 Go (96 Go alloués)128 Go : Mac Studio avec 192 Go ou plus
Meilleure qualité
Qwen3.8 27B 💡 🏠
Alternative plus rapide mesurée
Gemma 4 26B A4B ↯ 🏠
Repères de chargement, pas garanties : contexte, cache KV, batch et moteur changent l’empreinte. Les vitesses AIWB ont été mesurées sur la machine Strix Halo décrite dans À propos ; elles ne prédisent pas la vitesse d’une autre plateforme.
Comment « ça tient » est décidé
Une variante entre dans un palier quand son besoin mémoire estimé est inférieur ou égal à la taille du palier. L’estimation prend le fichier GGUF, plus 8 % pour les tampons du moteur, plus 2 Go pour un contexte court, le tout arrondi à la taille de carte standard supérieure. C’est prudent pour des consignes courtes et optimiste pour des documents longs : le chiffre « à 128K » de chaque carte indique ce que la même variante demande avec un contexte de 128 000 tokens, cache KV compris, et pour certains modèles il double le budget. Si vous travaillez sur de longs textes, lisez ce chiffre-là plutôt que la taille du fichier. Ces chiffres suivent les réglages par défaut de LM Studio, en gigaoctets décimaux comme lui : le fichier GGUF que nous avons testé (projecteur de vision compris quand il y en a un), plus le cache des couches à attention complète en F16 (les couches à fenêtre glissante et récurrentes ne grossissent presque pas, c’est pourquoi Gemma 4 et Qwen 3.x demandent bien moins qu’un calcul naïf), avec Flash Attention active, sans tampon d’attention supplémentaire. 128K désigne 131 072 tokens, le réglage proposé par LM Studio. Le tableau du classement permet aussi d’afficher un cache Q8, près de moitié moins lourd, et la taille des fichiers MLX pour les Mac.
Carte graphique dédiée ou mémoire unifiée
Une carte graphique offre la bande passante mémoire qui rend la génération rapide, mais sa taille est fixe : 8, 12, 16, 24 ou 32 Go sur les cartes grand public. Les machines à mémoire unifiée (Mac Apple Silicon, AMD Strix Halo, Nvidia DGX Spark) partagent un seul réservoir entre le processeur et la partie graphique. Elles accueillent des modèles qu’aucune carte grand public ne peut charger, mais ce réservoir est plus lent et n’est pas entièrement disponible pour le modèle. Comptez environ les trois quarts de la mémoire unifiée comme utilisables : c’est pourquoi un Mac de 24 Go se trouve dans le palier 16 Go et un Strix Halo de 64 Go dans le palier 48 Go. Les exemples sous chaque palier appliquent déjà cette règle.
Ce que la mémoire supplémentaire apporte
Au-delà de 32 Go, aucun modèle local plus gros n’écrit aujourd’hui mieux le français que les meilleures versions de 30 milliards de paramètres ; le premier choix cesse donc de changer et les paliers supérieurs fusionnent. La mémoire supplémentaire apporte tout de même trois choses : la version Q8 d’une famille plutôt que sa Q4 (la section sur la quantification montre où cela compte), un contexte long sans déborder dans la mémoire système, et la place pour garder deux modèles chargés. Ce qu’elle n’apporte pas, c’est la vitesse : la génération est limitée par la bande passante, et une carte de 24 Go est en général plus rapide qu’un réservoir unifié de 128 Go sur le même modèle.
À propos des vitesses
Les tokens par seconde ont été mesurés sur notre propre machine Strix Halo, décrite sur la page À propos, tokens de raisonnement compris. Ils comparent les variantes entre elles ; ils ne prédisent pas votre machine. Une carte dédiée génère typiquement deux à quatre fois plus vite que cette machine pour un modèle qui tient dans sa mémoire ; un processeur de portable sans accélérateur, beaucoup moins vite. Et quand une partie du modèle est déchargée sur le processeur, la vitesse chute nettement même si le modèle « tient ».
Pourquoi choisir une IA locale
Les raisons sont moins spectaculaires que les arguments publicitaires, et plus solides.
La confidentialité. Lorsque le moteur et ses intégrations fonctionnent entièrement en local, vos brouillons, vos notes et vos manuscrits n’ont pas à quitter la machine. Pour un texte sous contrat, un document interne ou un travail non publié, c’est déterminant.
Le fonctionnement hors ligne. Pas de connexion requise, pas de coupure de service, pas de file d’attente aux heures de pointe.
Le contrôle. Le modèle que vous avez téléchargé reste celui que vous avez téléchargé. Il n’est pas remplacé sans préavis par une version au comportement différent, et vous pouvez revenir à un checkpoint antérieur si le nouveau vous convient moins.
L’absence de dépendance. Ni quota, ni facturation à l’usage, ni changement de conditions au milieu d’un projet.
En contrepartie, il faut accepter que les meilleurs modèles locaux ne sont pas toujours au niveau des meilleurs modèles cloud, que la vitesse dépend de votre matériel, et qu’il y a un peu de bricolage initial. Le classement général du site vous dira où se situe précisément l’écart en français, sans avoir à nous croire sur parole.
Open source ou open-weight ?
Les deux termes circulent, souvent comme synonymes. Ils ne le sont pas. Poids ouverts signifie que les fichiers du modèle sont téléchargeables et exécutables ; open source décrit un statut de licence plus large, dont l’application exacte aux modèles d’IA reste débattue. Beaucoup de modèles très diffusés sont à poids ouverts sous licence restrictive, sans être open source au sens strict.
Le critère d’admission de cette page est technique : les poids sont disponibles et le modèle tourne réellement hors ligne. C’est ce qui détermine si vous pouvez l’utiliser chez vous. La licence, elle, détermine ce que vous avez le droit d’en faire : vérifiez-la avant tout usage commercial, elle ne dit rien de la qualité d’écriture.
Questions fréquentes
Quelle est la meilleure IA locale pour écrire en français ?
Celle qui occupe la première ligne du classement ci-dessus, à l’instant où vous le consultez. Le tableau est mis à jour à mesure que de nouveaux duels sont joués, et le nom en tête peut changer. Si votre matériel est limité, filtrez par quantification et consultez les recommandations par machine : la meilleure variante pour vous est la mieux classée qui tient confortablement dans votre mémoire.
Que veut dire « LLM local » ?
Un LLM, ou grand modèle de langage, est le type d’IA qui produit du texte. Un LLM local est un modèle que vous téléchargez et faites tourner sur votre propre ordinateur, hors ligne, au lieu d’interroger un service sur Internet.
Pourquoi une limite de 256 milliards de paramètres ?
Ce seuil garde la page centrée sur des modèles qu’un ordinateur personnel ou une station de travail compacte peut raisonnablement charger. Il porte sur le total des paramètres, y compris pour les modèles à mélange d’experts, puisque tous les poids doivent tenir en mémoire même quand une petite partie seulement travaille à chaque token. Les modèles plus gros ne sont pas impossibles à faire tourner chez soi ; ils sortent simplement du périmètre de cette page.
Combien de VRAM faut-il pour faire tourner un LLM local ?
Cela dépend entièrement de la variante et de la longueur de contexte souhaitée. Les recommandations par machine indiquent, de 8 à 128 Go, quelle variante classée tient avec la marge retenue ; lorsqu’aucune n’y tient, la carte le dit au lieu d’inventer une recommandation.
La mémoire unifiée vaut-elle la VRAM ?
En capacité, souvent mieux : une machine à mémoire unifiée charge des modèles qu’aucune carte grand public ne peut contenir. En bande passante, en général non, et la différence se voit dans la vitesse de génération. Les deux ne sont pas interchangeables : comptez environ les trois quarts de la mémoire unifiée comme utilisables par le modèle.
La quantification dégrade-t-elle la qualité du texte ?
Elle peut la modifier, dans une mesure qui dépend du modèle, de la méthode, de la langue et de la tâche. Nous ne publions un écart chiffré que lorsque nous disposons de comparaisons appariées sur le même modèle et le même mode de raisonnement. Méfiez-vous des pourcentages universels annoncés sans protocole.
Quelle différence entre Q4 QAT et Q4_K_M ?
La Q4 QAT est un checkpoint préparé ou entraîné en tenant compte d’une exécution en quatre bits. Le Q4_K_M est une quantification GGUF appliquée après l’entraînement, avec des précisions mixtes selon les couches. Même nombre de bits, origines différentes — et c’est pourquoi elles occupent deux lignes distinctes.
Que signifient les icônes 💡 et ↯ ?
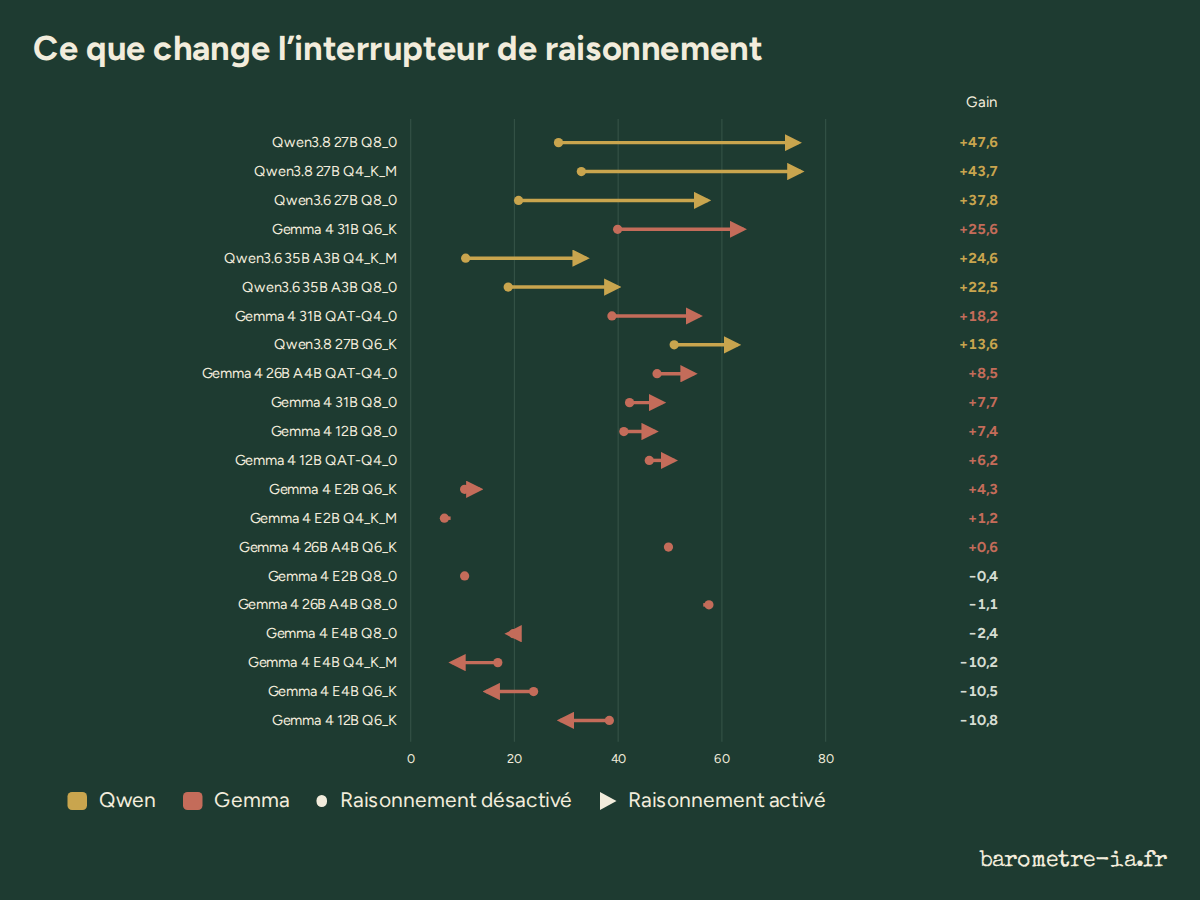
💡 indique que le mode de raisonnement était activé, ↯ qu’il était désactivé. Un troisième état, inconnu, signale les cas où le moteur d’exécution n’a rapporté aucun token de réflexion malgré la configuration demandée : nous préférons l’indiquer plutôt que de supposer.
Pourquoi les scores incluent-ils des duels contre des modèles cloud ?
Pour garder une échelle commune avec le classement général français et davantage de données derrière chaque score. Le rang affiché ici, en revanche, est bien un rang entre modèles locaux uniquement.
Un modèle « européen » écrit-il mieux en français ?
Pas par principe. L’origine d’un modèle ne présume pas de sa qualité en français : c’est précisément ce que le classement mesure, et les résultats ne suivent pas toujours l’intuition.
Est-ce que « ça tient en mémoire » veut dire « ça sera rapide » ?
Non. Un modèle peut se charger et rester lent, notamment si une partie des couches est déléguée au processeur. L’offload CPU permet d’exécuter des modèles plus gros que la mémoire de l’accélérateur, mais la pénalité de vitesse est réelle et parfois importante.
À quelle fréquence cette page est-elle mise à jour ?
En continu. Le classement, les filtres et les recommandations par machine sont générés à partir des données du Baromètre, et chaque nouveau lot de duels jugés peut faire bouger les scores. La génération de nouvelles réponses locales est suspendue depuis le 22 septembre 2026 ; les réponses déjà produites continuent d’être jugées.