IA locale
Un classement dynamique des modèles à poids ouverts pour écrire en français, avec filtres de quantification et repères mémoire.
Des enquêtes fondées sur les données du Baromètre pour mesurer comment les modèles, les réglages de génération et les protocoles d’évaluation influent sur la qualité des textes.
Un classement dynamique des modèles à poids ouverts pour écrire en français, avec filtres de quantification et repères mémoire.
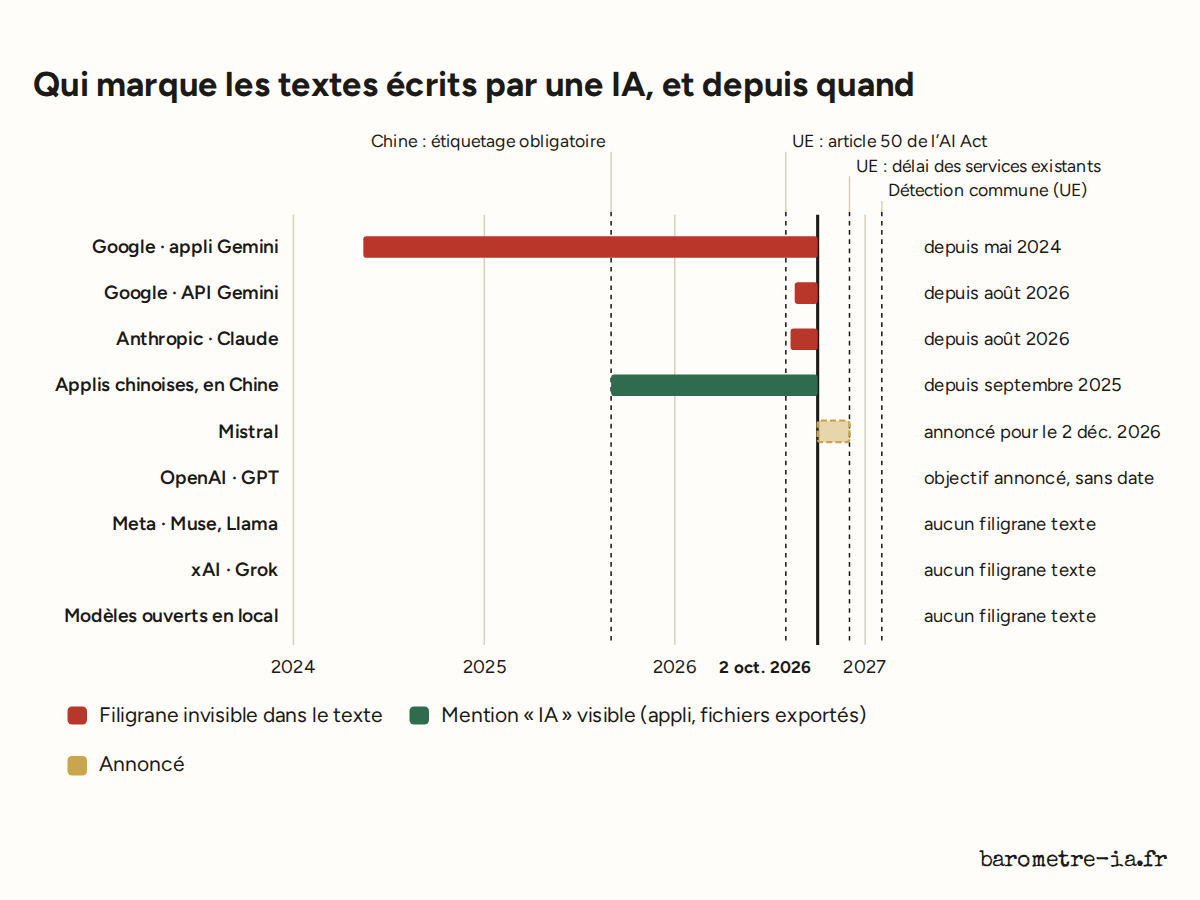
Depuis cet été, les textes de Claude et de Gemini portent une marque invisible ; depuis le 5 octobre, ceux de ChatGPT et de Codex aussi, en Europe, et l’API d’OpenAI peut être mise en demande pour poser la marque. Ceux de Grok, Mistral, Meta AI et des modèles installés sur son ordinateur n’en portent aucune, et les services chinois se contentent d’une mention visible. Mais personne, hors des entreprises concernées, ne peut aujourd’hui vérifier un texte.
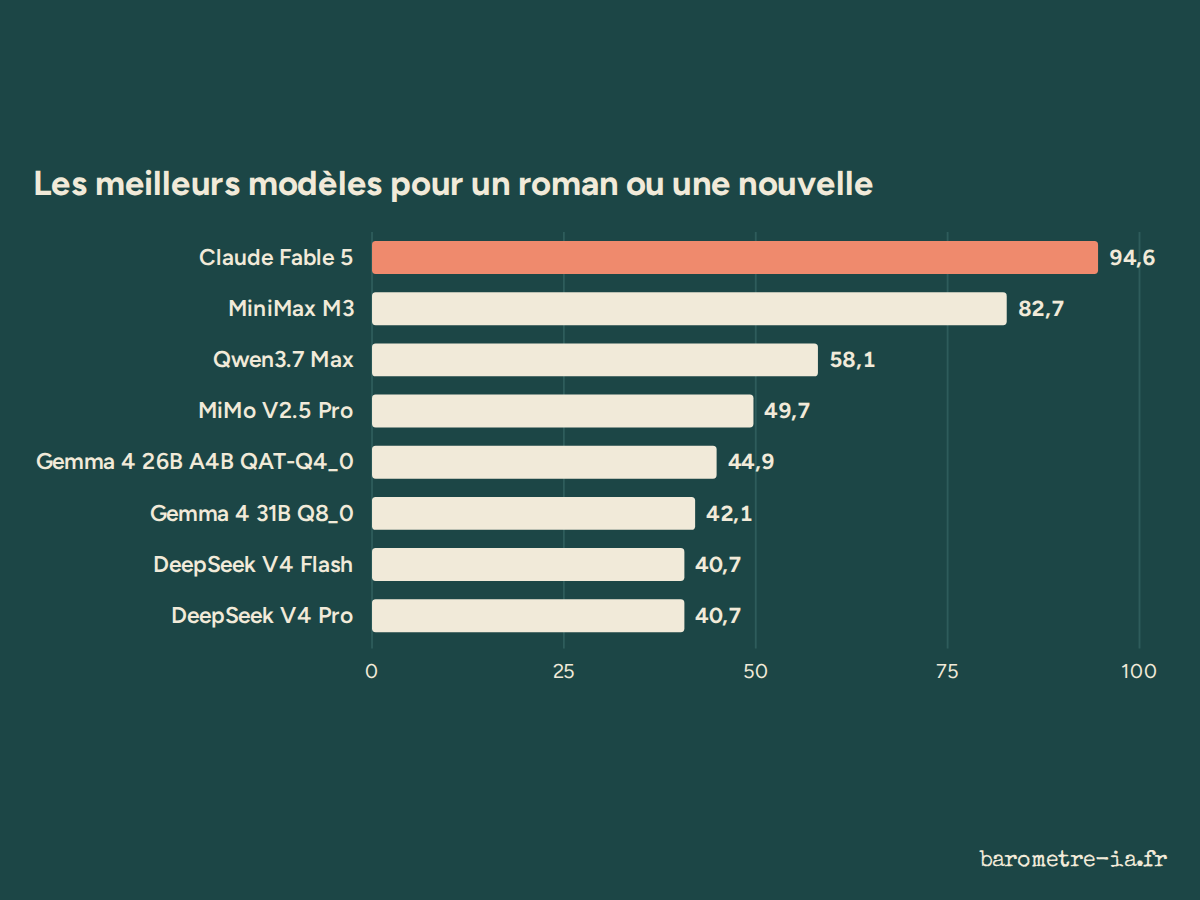
Le classement a un vainqueur ; vos textes n’en ont pas un seul. Au 20 septembre, sur les seuls duels d’un type de texte, Claude Fable 5 dominait la fiction et la dissertation, Claude Opus 5 les lettres personnelles, Claude Fable 5.1 les lettres de motivation. Un guide simple, tâche par tâche, avec le meilleur fichier à faire tourner chez soi pour chacune.
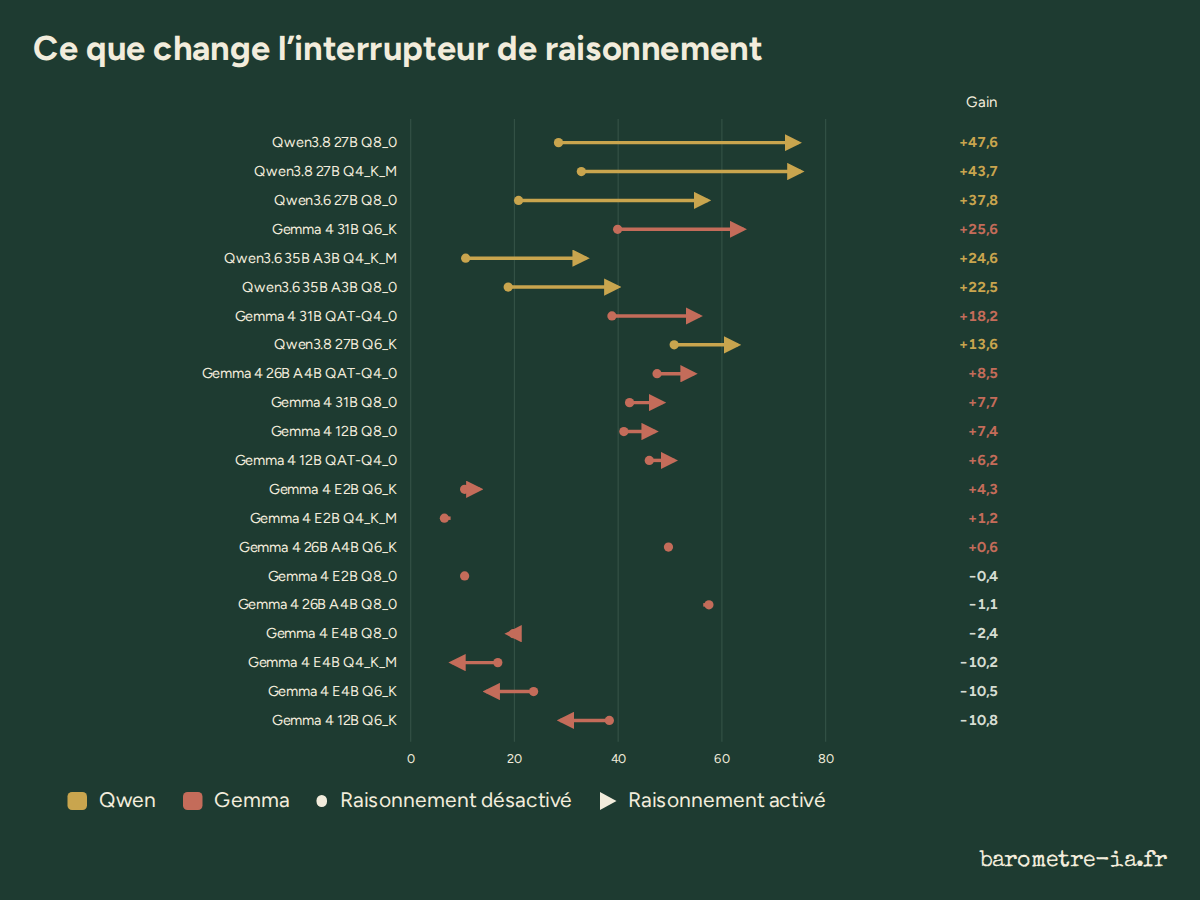
Même fichier, mêmes consignes, un seul interrupteur. Sur 21 versions locales, activer le raisonnement rapporte en moyenne 32 points à la famille Qwen et 7 aux Gemma 4 de 12B et plus ; les petits Gemma E2B et E4B y perdent 3 points en moyenne. Qwen3.8 27B Q8_0 gagne 48 points, plus que tout autre modèle en français.
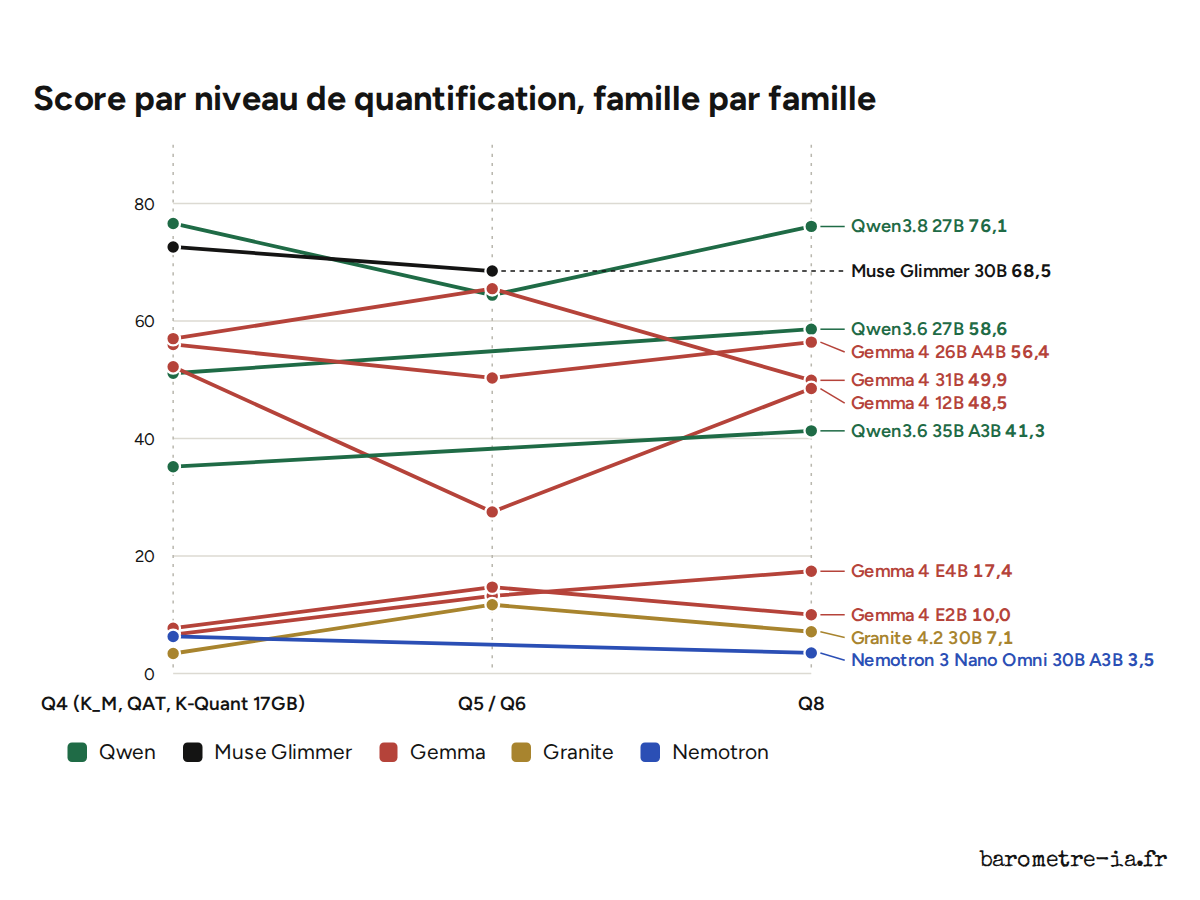
Même modèle, trois fichiers, trois scores. En français, Qwen3.8 27B écrit aussi bien en Q4_K_M qu’en Q8_0 avec un fichier deux fois plus petit, mais sa version Q6_K perd douze points. Gemma 4 31B fait mieux en Q6 qu’en Q8. Gemma 4 12B s’effondre en Q6 et tient en Q4. Il n’y a pas de règle générale, seulement des mesures.
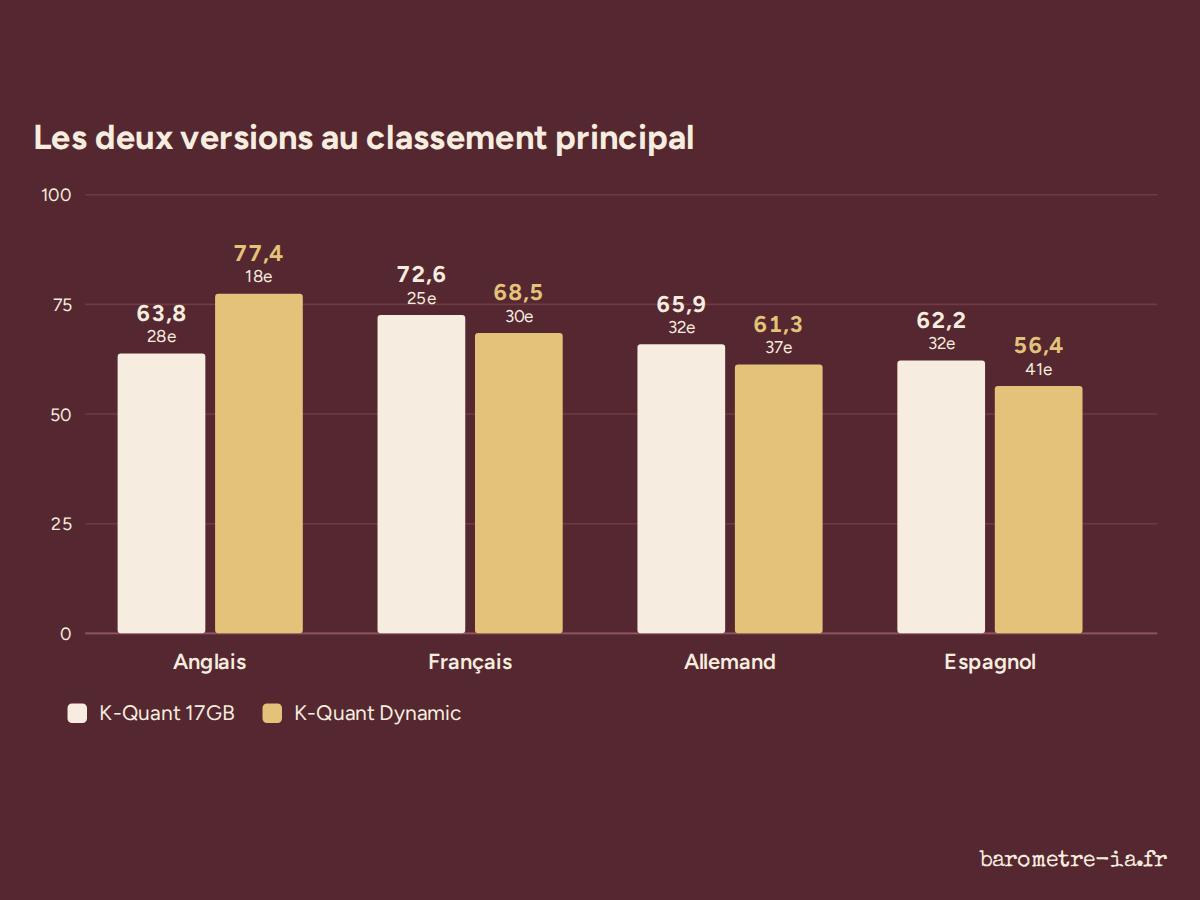
Le modèle ouvert de Meta est dans les cinq meilleurs modèles locaux pour l’écriture en français, à 72,6 points avec la version K-Quant 17GB. La version Dynamic, plus grosse et donnée pour meilleure par Meta, fait 68,5 et perd 16 duels directs sur 26. Le fichier à télécharger en français est le petit ; en anglais, c’est l’inverse.
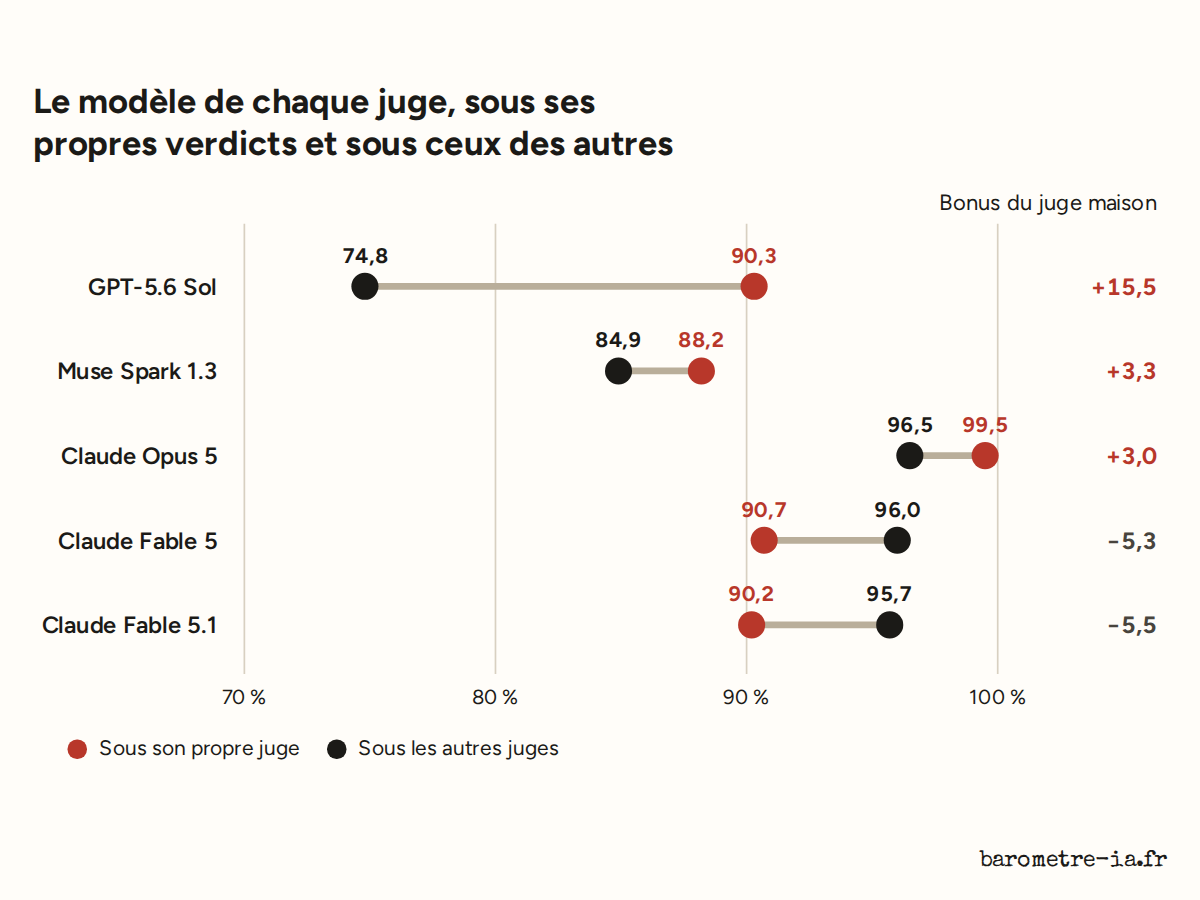
Quand GPT-5.6 Sol juge un duel où figure GPT-5.6 Sol, ses propres textes récoltent 90 % des points ; sous les autres juges, 75 %. Claude Opus 5 penche du même côté, plus légèrement. Les deux juges Claude Fable font l’inverse et se notent plus sévèrement que les autres.
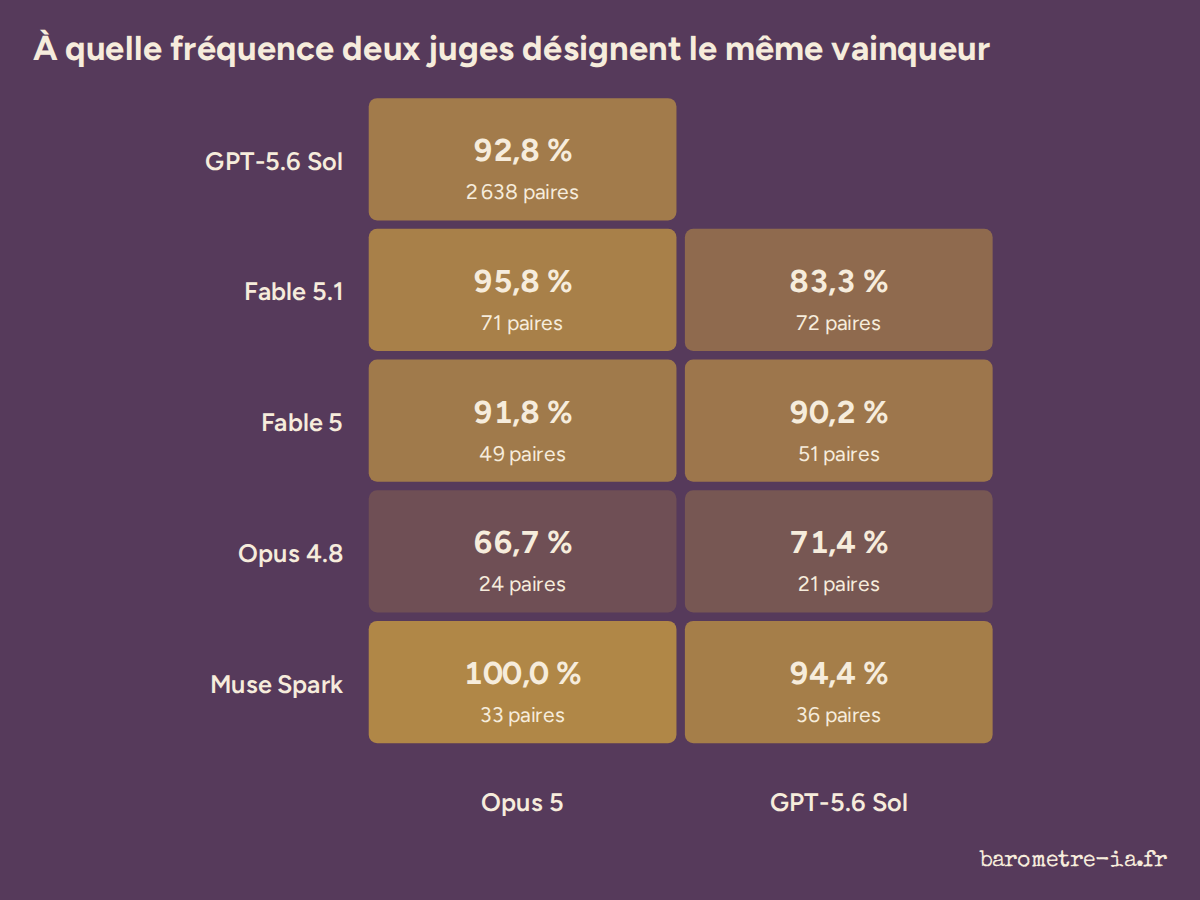
Claude Opus 5 et GPT-5.6 Sol, qui fournissent 85 % des verdicts, donnent raison au même modèle sur 93 % des 2 600 paires de modèles qu’ils ont jugées tous les deux. Claude Opus 4.8 ne les suit que deux fois sur trois, et sur les égalités personne n’est d’accord : GPT-5.6 Sol en déclare une pour mille duels, Claude Fable 5.1 une pour quinze.
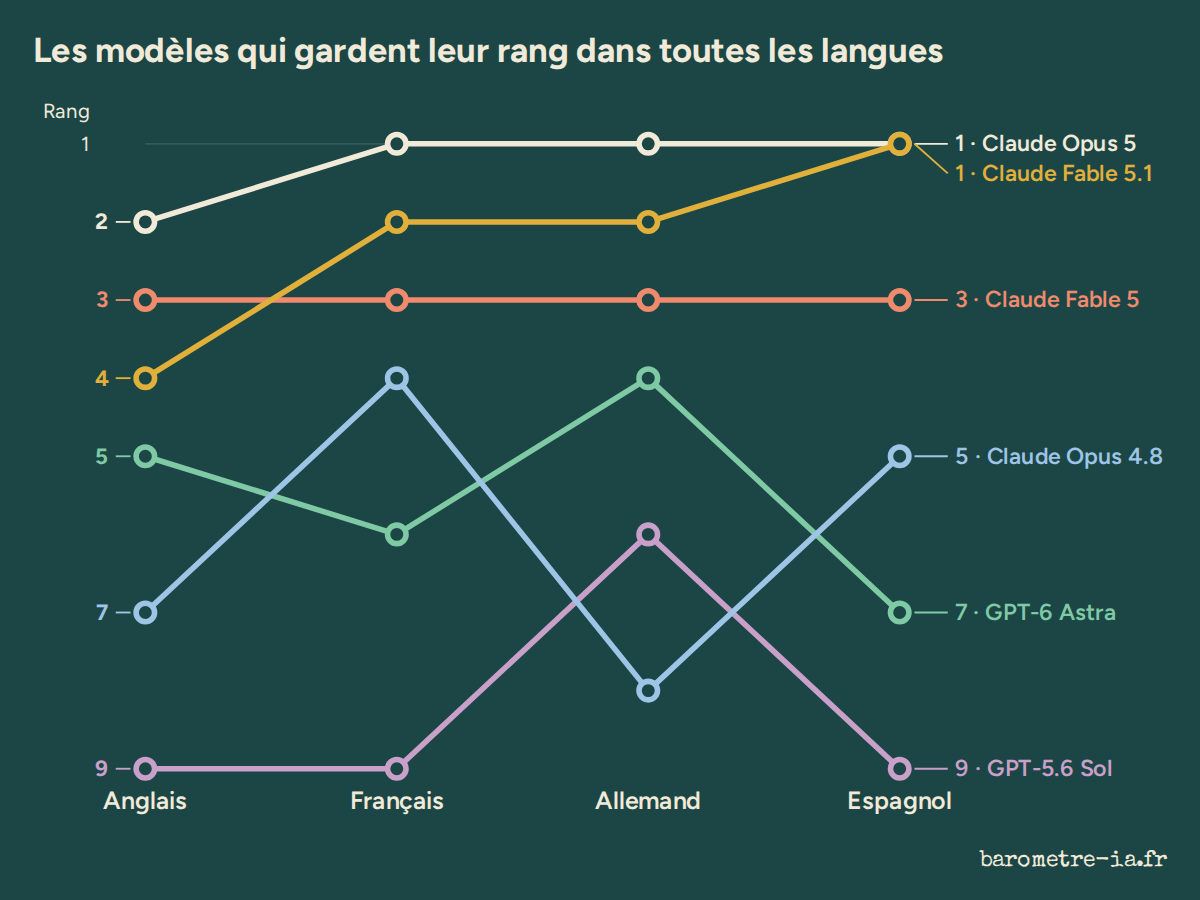
Quatre-vingt-onze modèles sont classés en anglais, en français, en allemand et en espagnol selon le même protocole. Au 19 septembre, Claude Fable 5 était troisième dans les quatre langues, Claude Opus 5 premier en français. Plus bas, Grok 4.6 était 25e en anglais et 60e en français, et Qwen3.8 27B le meilleur modèle local en français mais l’un des plus faibles en allemand.
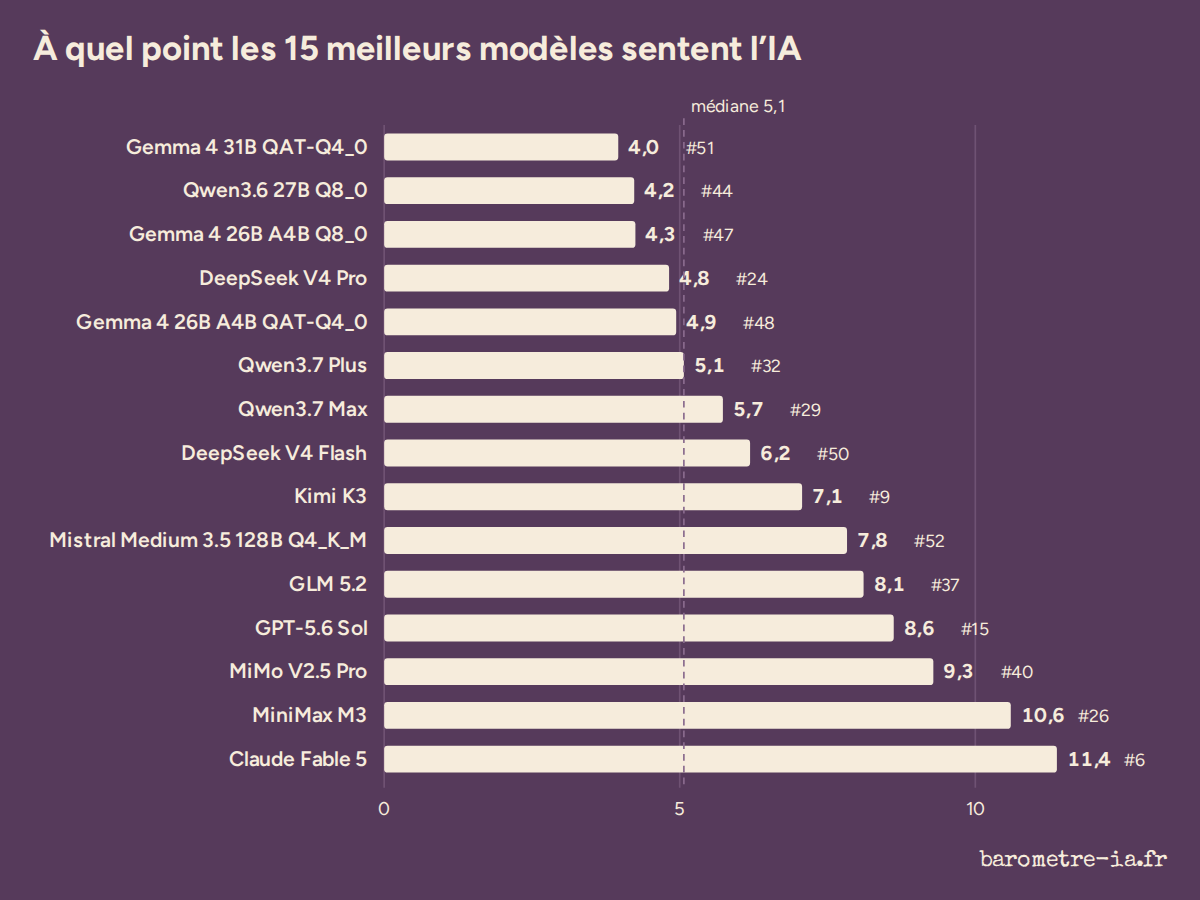
Nous avons compté, dans 3 574 textes classés en français, les marques que les lecteurs appellent « de l’IA » : tirets cadratins, formules toutes faites, « non pas X mais Y », listes de trois, calques de l’anglais. Claude Fable 5, alors troisième du classement, en a le plus ; les modèles les plus sobres sont des fichiers locaux en milieu de tableau. Et « véritable » apparaît 494 fois.