Q4, Q6 ou Q8 : la quantification ne coûte rien sur certains modèles et douze points sur d’autres
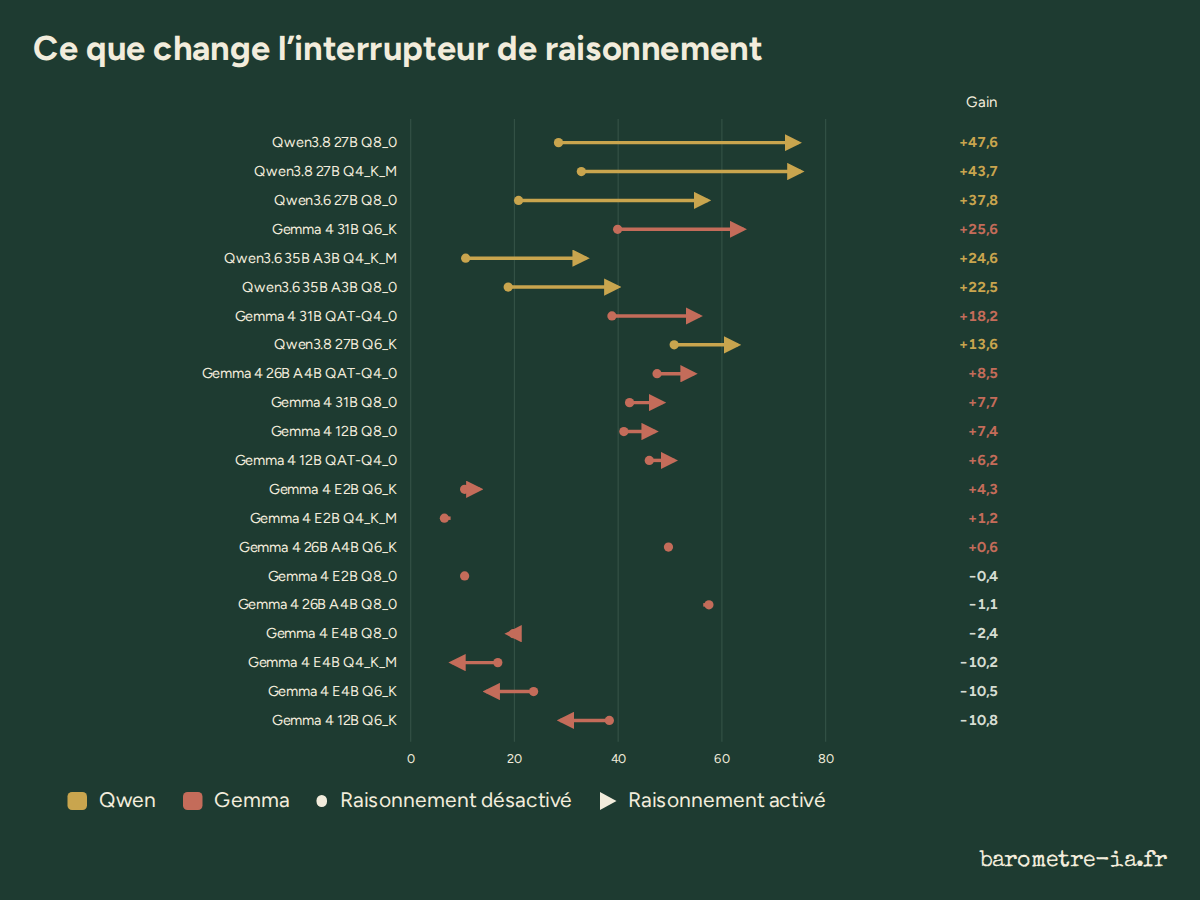
Même modèle, trois fichiers, trois scores. En français, Qwen3.8 27B écrit aussi bien en Q4_K_M qu’en Q8_0 avec un fichier deux fois plus petit, mais sa version Q6_K perd douze points. Gemma 4 31B fait mieux en Q6 qu’en Q8. Gemma 4 12B s’effondre en Q6 et tient en Q4. Il n’y a pas de règle générale, seulement des mesures.
La quantification réduit un modèle en stockant ses poids sur moins de bits. Un modèle de 27 milliards de paramètres, Qwen3.8 27B, pèse 30 Go en Q8_0 et 17,7 Go en Q4_K_M : c’est la différence entre tenir sur une carte de 24 Go ou non. Tous les guides disent que le fichier plus petit écrit un peu moins bien. Nous avons mesuré combien, sur des consignes en français, avec les mêmes duels à l’aveugle que ceux qui construisent le classement, environ 1 000 à 1 800 par version. Les scores sont ceux du classement français au 20 septembre 2026 : 50 signifie une chance sur deux de battre le modèle moyen.
Même modèle, trois fichiers, trois scores : les lignes ne sont pas parallèles
Score par niveau de quantification, famille par famille
Score de chaque version avec le raisonnement activé. Les lignes relient les versions d’une même famille ; fichiers 4 bits à gauche, 8 bits à droite.
- Qwen
- Muse Glimmer
- Gemma
- Granite
- Nemotron
Voir les données en tableau
| Famille | Q4 (K_M, QAT, K-Quant 17GB) | Q5 / Q6 | Q8 |
|---|---|---|---|
| Qwen3.8 27B | 76,6 | 64,4 | 76,1 |
| Muse Glimmer 30B | 72,6 | 68,5 | — |
| Qwen3.6 27B | 51,1 | — | 58,6 |
| Gemma 4 26B A4B | 56,0 | 50,3 | 56,4 |
| Gemma 4 31B | 57,0 | 65,5 | 49,9 |
| Gemma 4 12B | 52,2 | 27,5 | 48,5 |
| Qwen3.6 35B A3B | 35,2 | — | 41,3 |
| Gemma 4 E4B | 6,6 | 13,2 | 17,4 |
| Gemma 4 E2B | 7,7 | 14,7 | 10,0 |
| Granite 4.2 30B | 3,4 | 11,7 | 7,1 |
| Nemotron 3 Nano Omni 30B A3B | 6,3 | — | 3,5 |
Si la quantification était un impôt fixe, toutes les lignes monteraient de gauche à droite de la même pente. Ce n’est pas le cas : certaines sont plates, plusieurs descendent, une ou deux plongent. C’est tout le résultat ; la suite de l’article parcourt les lignes.
Là où la quantification est gratuite : Qwen3.8 27B ne perd rien en Q4
Qwen3.8 27B écrit le français aussi bien en Q4_K_M, 76,6, qu’en Q8_0, 76,1, sur plus de 1 300 duels chacun. Le fichier de 17,7 Go est celui à télécharger, et c’était à cette date le meilleur modèle local de l’édition française. Gemma 4 26B A4B est presque aussi indifférent : ses versions Q8 et QAT-Q4 se tiennent en un demi-point, 56,4 et 56,0.
Là où elle coûte cher : Gemma 4 12B perd vingt-cinq points en Q6, Qwen3.8 douze
C’est la surprise française : ce n’est pas le Q4 qui fait mal, c’est le Q6. Gemma 4 12B tombe de 52,2 en QAT-Q4_0 à 27,5 en Q6_K, avec le Q8_0 entre les deux à 48,5. Qwen3.8 27B perd douze points en Q6_K, 64,4, alors que ses deux autres versions dépassent 76. Gemma 4 31B, elle, fait l’inverse : 65,5 en Q6_K, 57,0 en QAT et 49,9 en Q8_0, le fichier le plus gros étant le moins bon. Granite 4.2 30B est faible dans les trois cas, de 3,4 à 11,7.
Le Q6 est rarement la réponse
Sur les sept familles testées en Q6_K, le Q6_K n’est le meilleur de sa famille en français que pour Gemma 4 31B et pour deux familles aux scores très faibles, Gemma 4 E2B et Granite 4.2 30B ; il est le pire pour Qwen3.8 27B, Gemma 4 12B et Gemma 4 26B A4B. Il économise moins de mémoire que le Q4, et sa qualité face au Q8 est imprévisible. À choisir à l’aveugle, prenez le Q8 s’il tient, un Q4 QAT ou K-Quant sinon, et évitez le Q6.
Ce qui tient dans 16 et 24 Go, et ce que cela coûte en points
Taille du fichier et score
Chaque version du tableau : taille du fichier GGUF et score. Les pointillés marquent 16 Go et 24 Go de mémoire.
- Qwen
- Muse Glimmer
- Gemma
- Granite
- Nemotron
Voir les données en tableau
| Modèle | Taille du fichier (Go) | Score |
|---|---|---|
| Qwen3.8 27B Q4_K_M | 16,8 | 76,6 |
| Qwen3.8 27B Q8_0 | 29,0 | 76,1 |
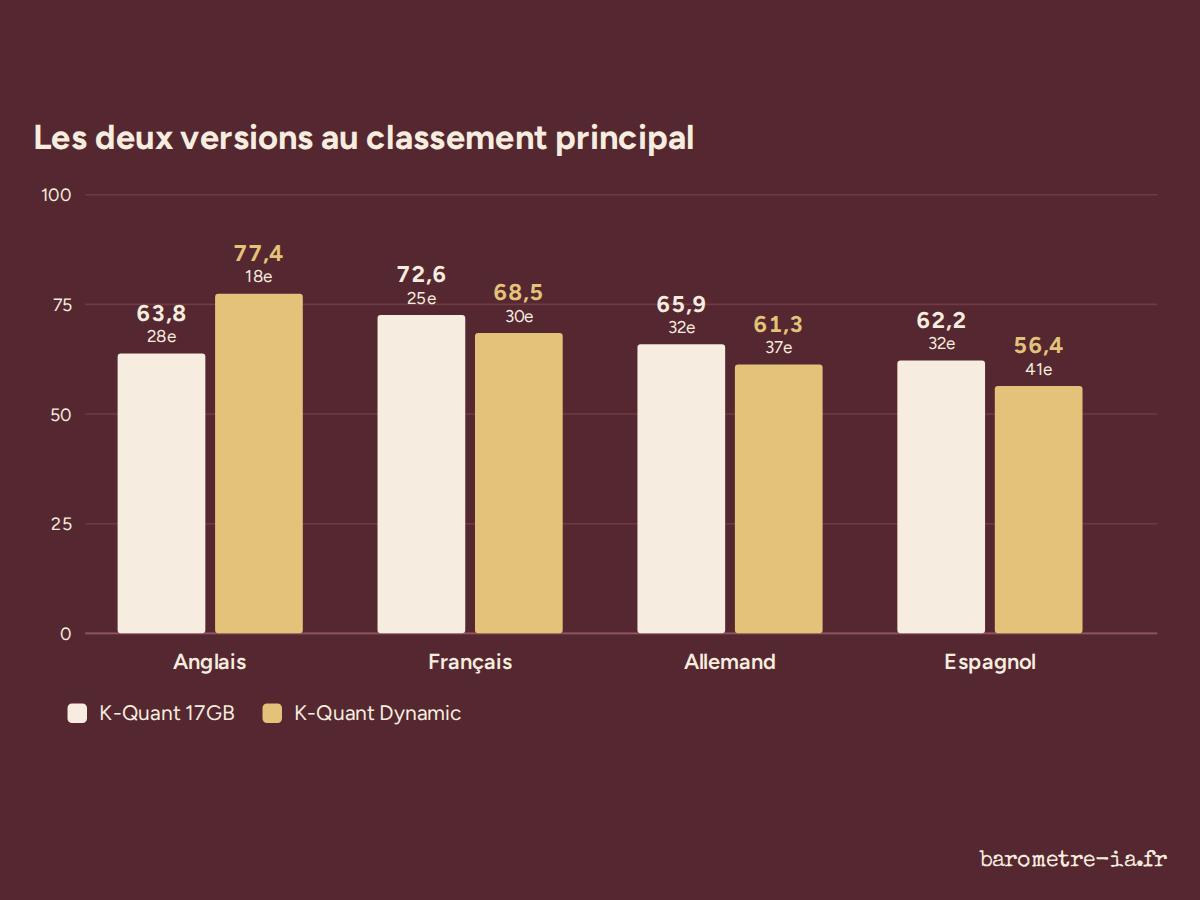
| Muse Glimmer 30B K-Quant 17GB | 16,8 | 72,6 |
| Muse Glimmer 30B K-Quant Dynamic | 19,7 | 68,5 |
| Gemma 4 31B Q6_K | 25,2 | 65,5 |
| Qwen3.8 27B Q6_K | 22,4 | 64,4 |
| Qwen3.6 27B Q8_0 | 28,6 | 58,6 |
| Gemma 4 31B QAT-Q4_0 | 17,7 | 57,0 |
| Gemma 4 26B A4B Q8_0 | 26,9 | 56,4 |
| Gemma 4 26B A4B QAT-Q4_0 | 14,4 | 56,0 |
| Gemma 4 12B QAT-Q4_0 | 7,0 | 52,2 |
| Qwen3.6 27B Q4_K_M | 16,5 | 51,1 |
| Gemma 4 26B A4B Q6_K | 22,6 | 50,3 |
| Gemma 4 31B Q8_0 | 32,6 | 49,9 |
| Gemma 4 12B Q8_0 | 12,7 | 48,5 |
| Qwen3.6 35B A3B Q8_0 | 36,9 | 41,3 |
| Qwen3.6 35B A3B Q4_K_M | 21,2 | 35,2 |
| Gemma 4 12B Q6_K | 9,8 | 27,5 |
| Gemma 4 E4B Q8_0 | 8,0 | 17,4 |
| Gemma 4 E2B Q6_K | 3,8 | 14,7 |
| Gemma 4 E4B Q6_K | 6,2 | 13,2 |
| Granite 4.2 30B Q6_K | 24,0 | 11,7 |
| Gemma 4 E2B Q8_0 | 5,0 | 10,0 |
| Gemma 4 E2B Q4_K_M | 3,4 | 7,7 |
| Granite 4.2 30B Q8_0 | 31,1 | 7,1 |
| Gemma 4 E4B Q4_K_M | 5,3 | 6,6 |
| Nemotron 3 Nano Omni 30B A3B Q4_K_M | 24,5 | 6,3 |
| Nemotron 3 Nano Omni 30B A3B Q8_0 | 33,6 | 3,5 |
| Granite 4.2 30B Q4_K_M | 17,7 | 3,4 |
Les pointillés marquent les deux plafonds de mémoire courants. Sous 16 Go, le meilleur rédacteur est Gemma 4 26B A4B QAT-Q4_0 (15,6 Go) à 56,0. Sous 24 Go, Qwen3.8 27B Q4_K_M (17,7 Go) prend la tête à 76,6, devant tous les fichiers de 30 Go du diagramme, suivi de Muse Glimmer 17GB (18,2 Go) à 72,6. Les versions Q8 des modèles de 26 à 35 milliards de paramètres, à droite, pèsent 28 à 38 Go et n’apportent, pour la plupart des familles, que quelques points au mieux. Au-delà de 24 Go, la mémoire est mieux employée pour un modèle plus gros que pour une quantification plus lourde du même modèle.
La même mesure en anglais, en allemand et en espagnol donne d’autres réponses
Rien de tout cela ne se transpose. En anglais, le Q4 de Qwen3.8 est le meilleur de sa famille et Gemma 4 12B Q6 se porte bien ; en allemand, Qwen3.8 perd 21 points entre Q8 et Q4 ; en espagnol, 27. Chaque édition de cet article est écrite à partir des duels de sa langue ; si vous écrivez dans l’une d’elles, lisez celle-là.
Conclusion
La quantification n’est pas un impôt fixe. En français, Qwen3.8 27B ne perd rien en Q4 mais douze points en Q6 ; Gemma 4 31B écrit mieux en Q6 qu’en Q8 ; Gemma 4 12B perd vingt-cinq points en Q6. Vérifiez le fichier précis dans le diagramme avant de croire un pourcentage général, et méfiez-vous du Q6.