Je m’appelle Johannes Eva et je crée des sites web depuis 27 ans. Le Baromètre est né d’un manque : aucun classement existant ne mesurait ce qui m’intéressait, la qualité d’écriture des modèles d’IA en français.
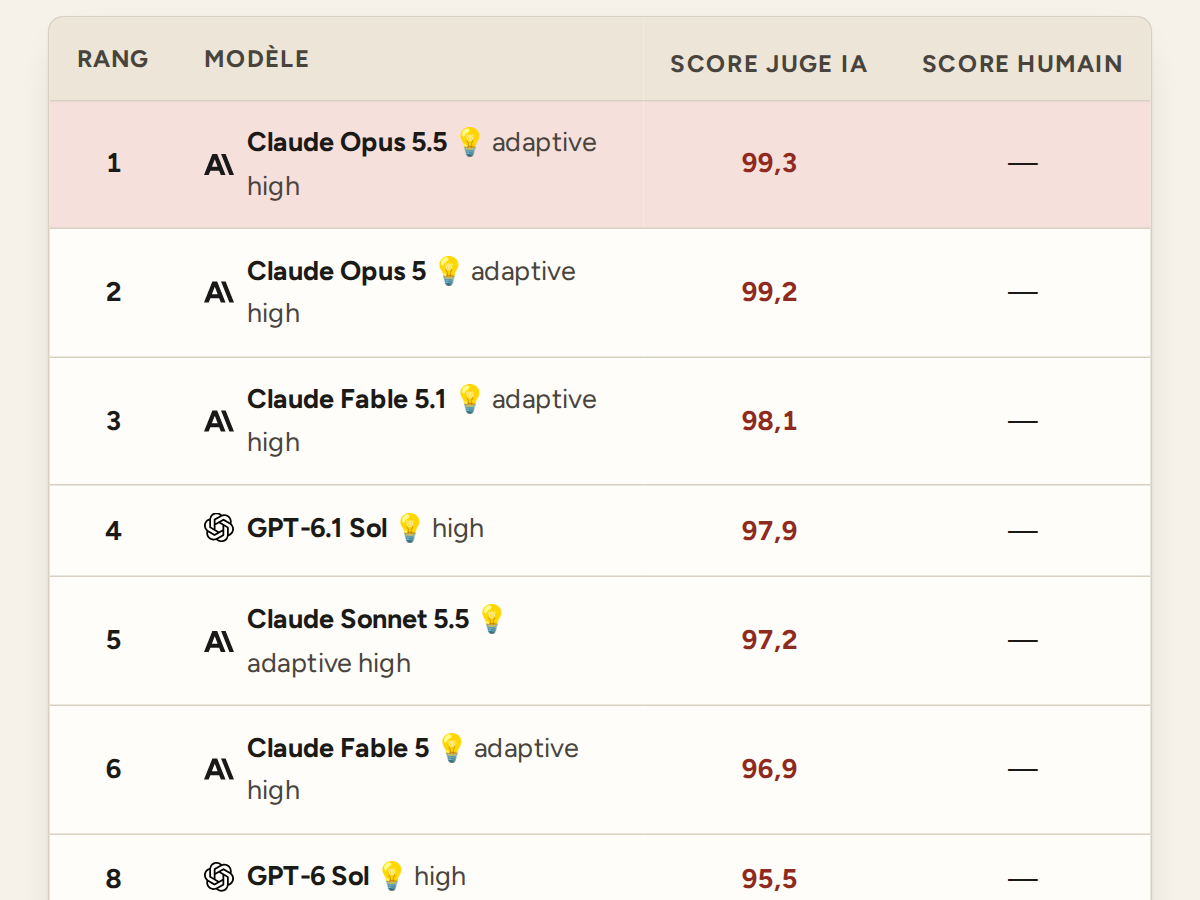
Les benchmarks publics privilégient le code, les mathématiques et le raisonnement. Le peu qu’ils consacrent à l’écriture est presque toujours jugé en anglais. Ici, seule compte la qualité des textes générés. Les consignes sont pensées directement en français et les réponses sont comparées à l’aveugle.
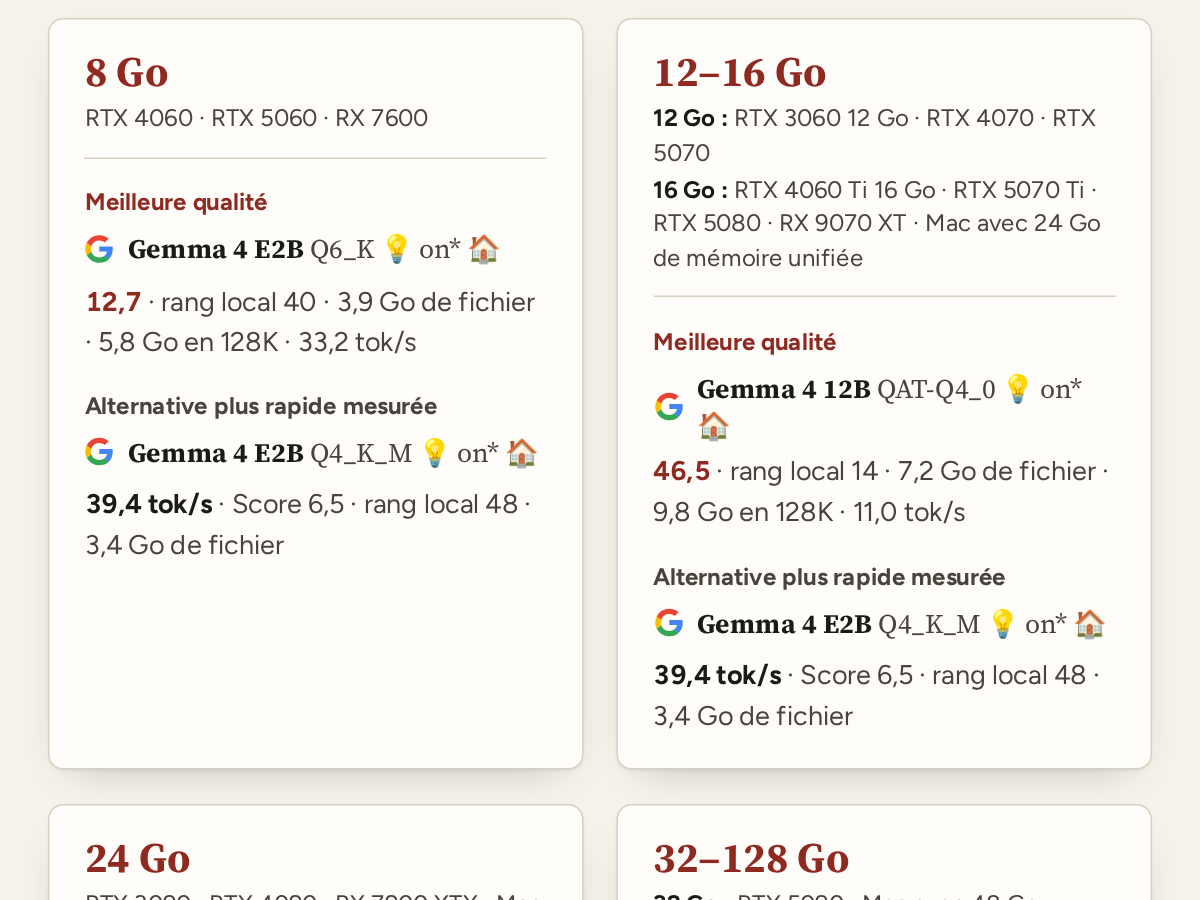
Une place particulière revient aux modèles qu’on peut faire tourner chez soi. Les familles Gemma 4, Qwen 3.6 et 3.8, Ling 3.0 Flash, Muse Glimmer ou Granite 4.2, entre autres, sont signalées par 🏠. Elles ont été exécutées localement, dans plusieurs quantifications, raisonnement activé et désactivé. La génération locale est suspendue depuis le 22 septembre 2026 ; les réponses déjà produites continuent d’être jugées.
Ce site est un projet personnel. Je ne suis payé par aucun éditeur de modèles et je n’ai aucun intérêt à en favoriser un.
Les machines utilisées pour les modèles locaux
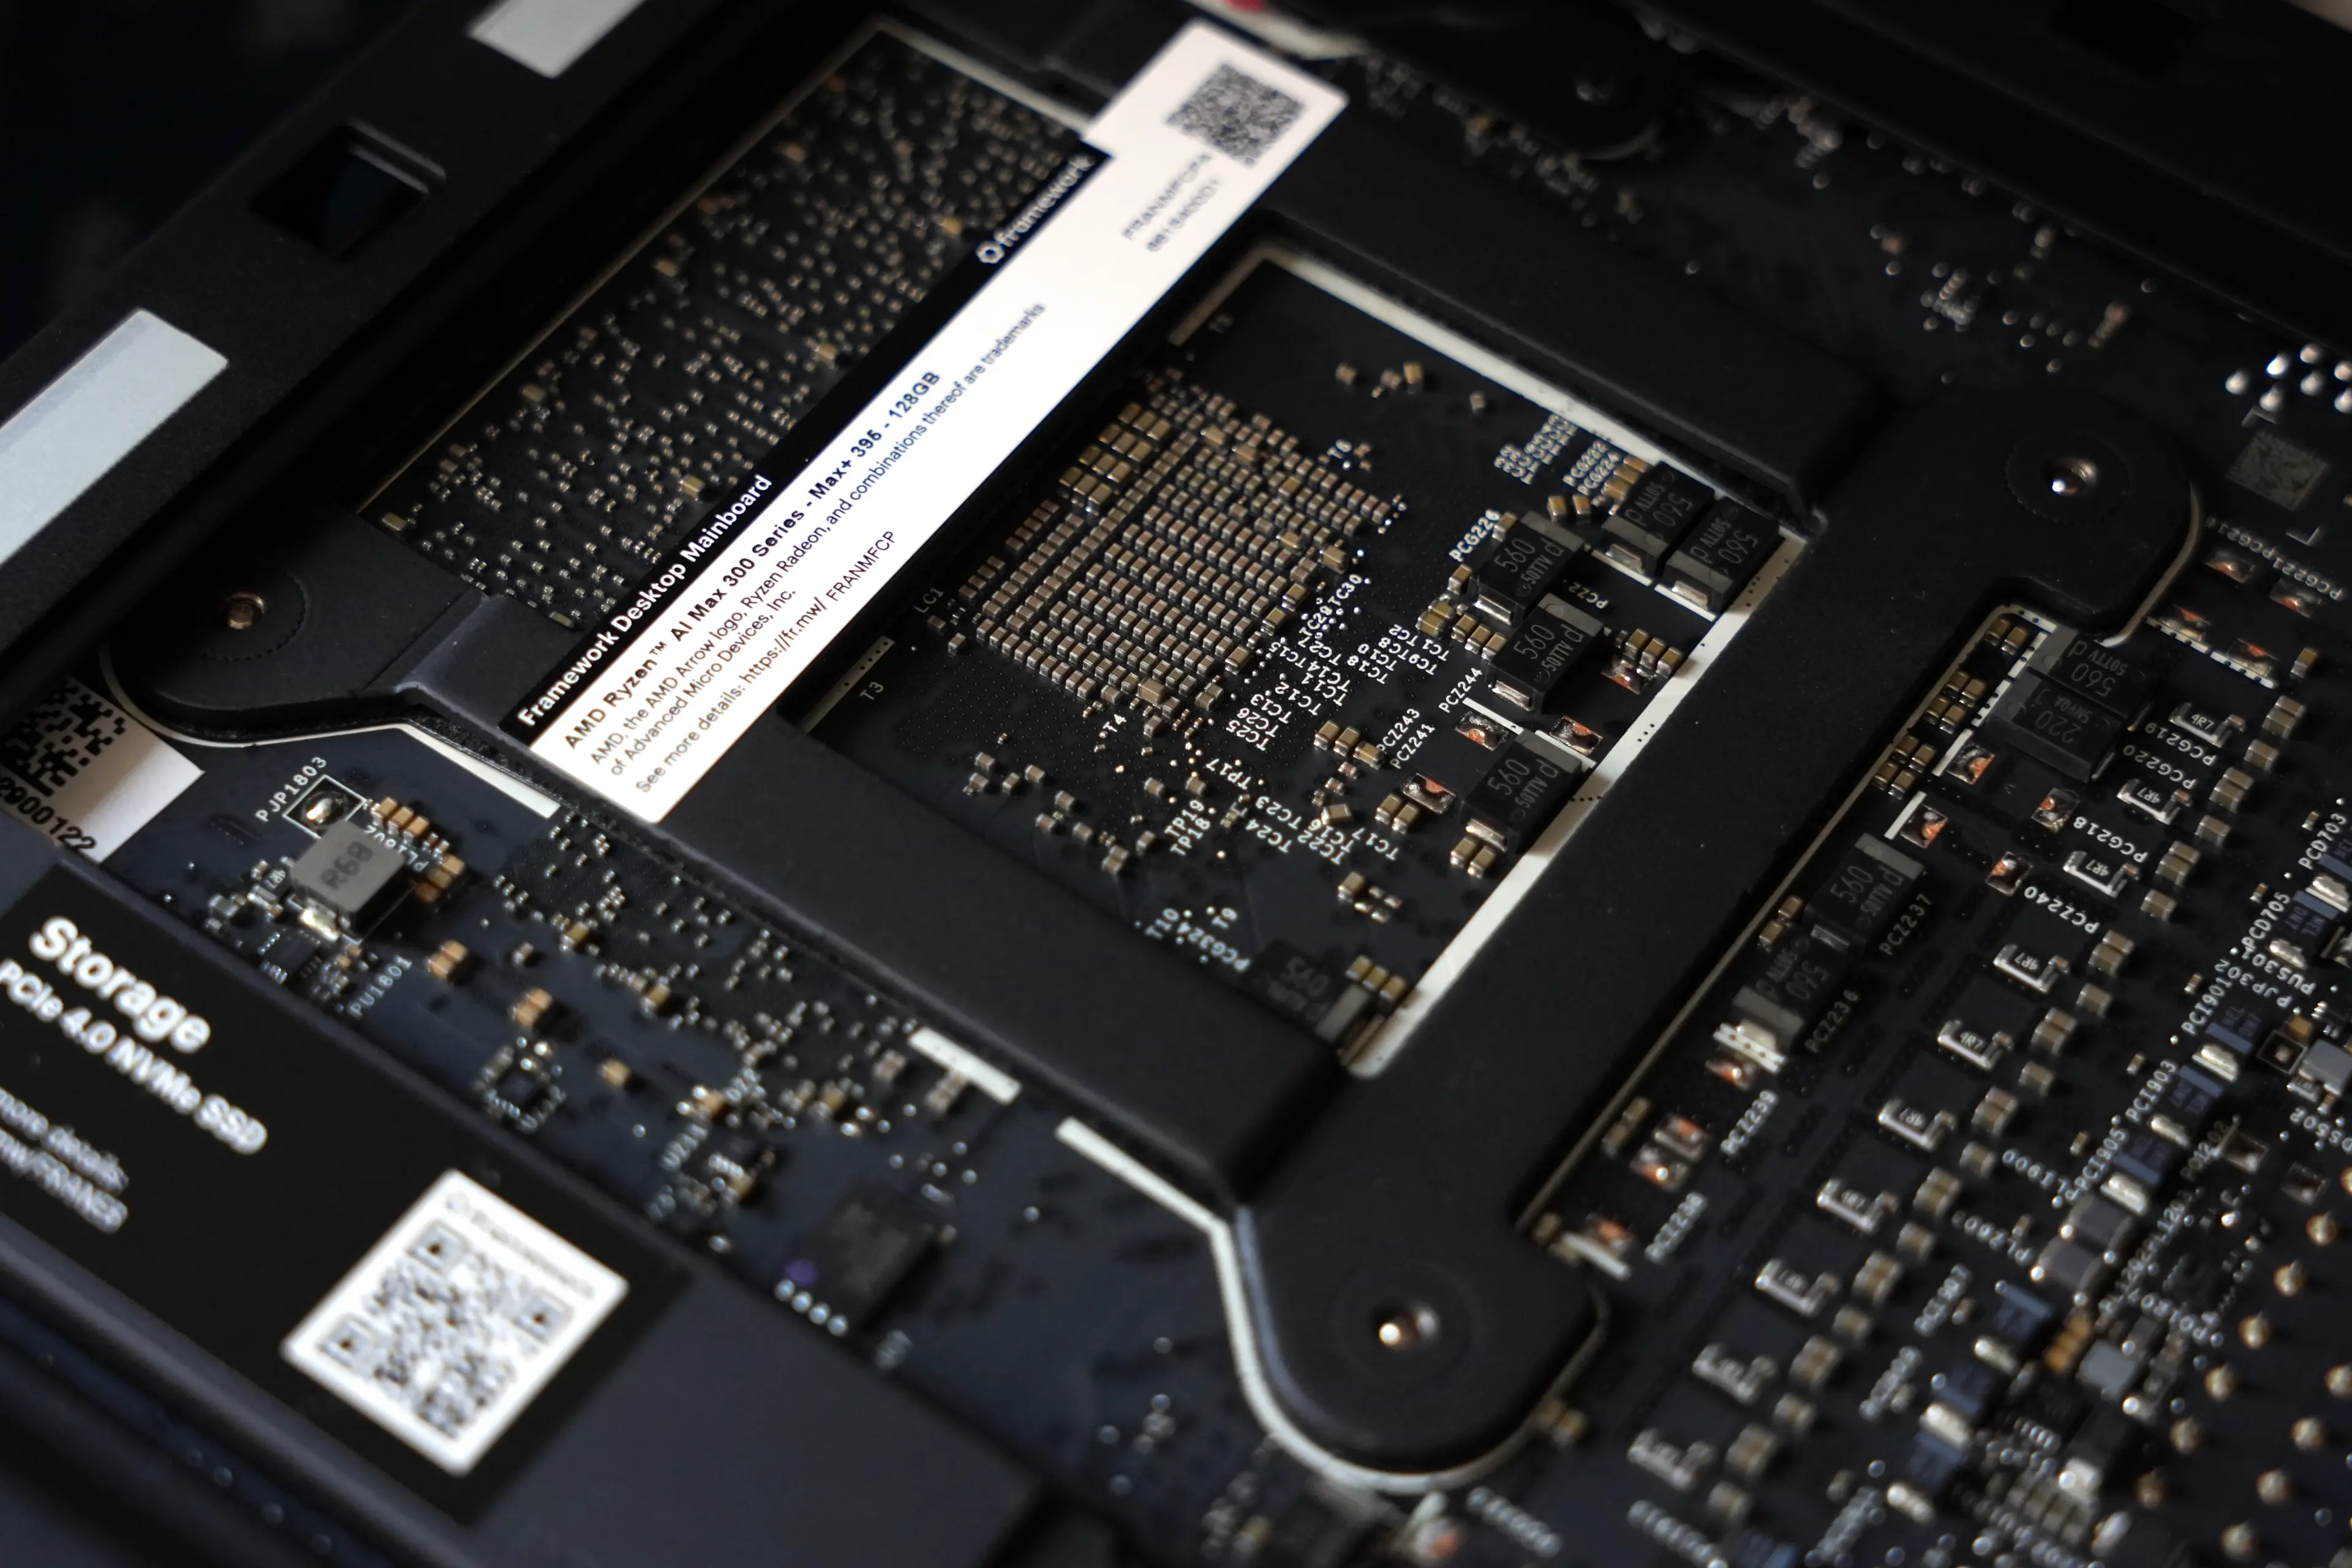
- Ordinateur
- Framework Desktop, AMD Ryzen AI Max série 300, révision A6
- Processeur
- AMD Ryzen AI Max+ 395, 16 cœurs et 32 threads, jusqu’à 5,19 GHz
- Partie graphique
- AMD Radeon 8060S intégrée
- Mémoire
- 128 Go de mémoire unifiée, partagée entre le processeur et la partie graphique
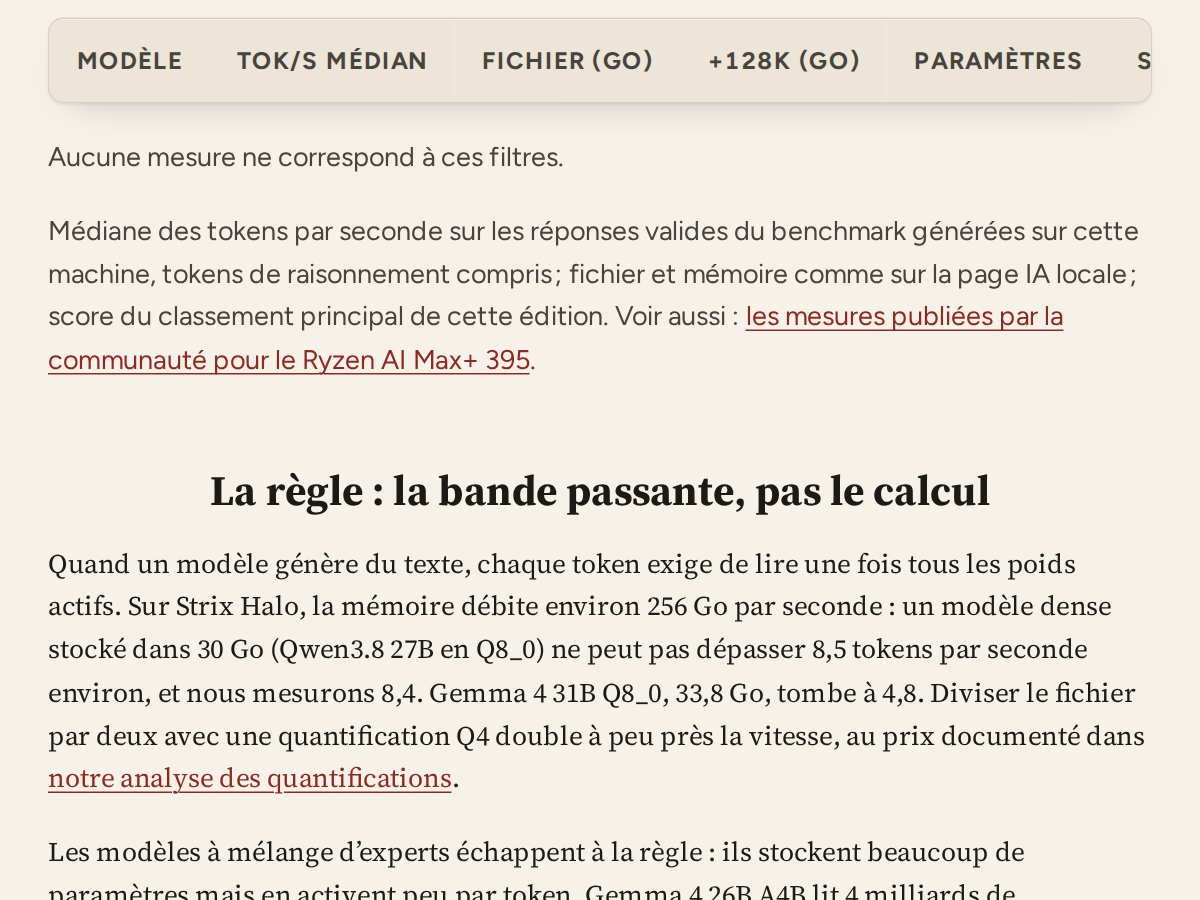
Les modèles locaux ont été exécutés sur un Framework Desktop équipé d’un AMD Ryzen AI Max+ 395. Ses 128 Go de mémoire unifiée sont accessibles au processeur comme à la partie graphique, ce qui permet de charger des modèles plus volumineux que sur la plupart des cartes graphiques grand public. Une seconde machine dotée d’une NVIDIA GeForce RTX 5070 Ti a servi aux modèles les plus légers.
Les vitesses de génération mesurées sur cette machine, modèle par modèle et quantification par quantification, sont sur la page Vitesse Strix Halo.