Strix Halo est le nom de code de la série Ryzen AI Max d’AMD, la première puce pour PC dotée d’assez de mémoire unifiée pour charger des modèles qui exigeaient jusque-là une armoire de cartes graphiques. Notre machine est un Framework Desktop : 16 cœurs, une Radeon 8060S intégrée et 128 Go de LPDDR5X partagés entre le processeur et la partie graphique. C’est une configuration courante, un peu plus de 2 000 euros, et la question qu’on se pose à son sujet est toujours la même : qu’est-ce qu’elle fait tourner, et à quelle vitesse ?
Nous pouvons répondre par des mesures plutôt que par des estimations, parce que le Baromètre lui-même y a généré des milliers de textes. Le tableau donne, pour chaque fichier testé, la médiane des tokens par seconde sur les réponses valides générées sur cette machine, tokens de raisonnement compris, à côté de la taille du fichier, de la mémoire nécessaire avec un contexte de 128 000 tokens rempli, et du score d’écriture du modèle dans le classement de cette édition.
| Modèle | Tok/s médian | Fichier (Go) | +128K (Go) | Paramètres | Score | Réponses |
|---|---|---|---|---|---|---|
 Gemma 4 26B A4B 💡 🏠 | 39,8 | 28,1 | 31,0 | 26,0 B (4,0 B actifs) | 50,5 | 465 |
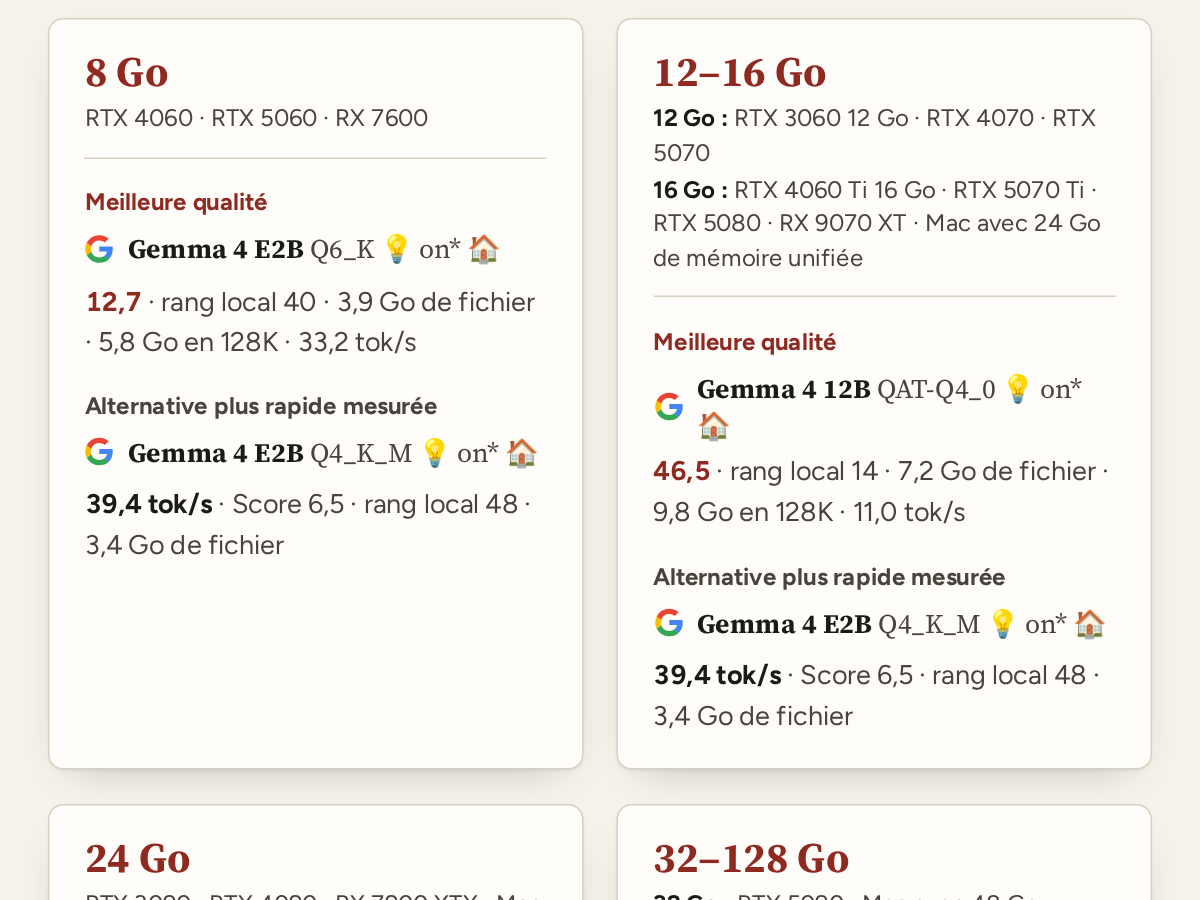
| Gemma 4 E2B 💡 🏠 | 39,4 | 3,4 | 5,3 | 5,1 B | 6,8 | 224 |
| Gemma 4 E4B 💡 🏠 | 35,9 | 8,0 | 11,9 | 8,0 B | 15,3 | 542 |
| Gemma 4 E2B 💡 🏠 | 33,2 | 3,9 | 5,8 | 5,1 B | 12,9 | 216 |
 Ling 3.0 Flash 💡 🏠 | 31,6 | 77,0 | 78,2 | 124,0 B (5,1 B actifs) | 53,0 | 277 |
| Ling 3.0 Flash ↯ 🏠 | 30,5 | 77,0 | 78,2 | 124,0 B (5,1 B actifs) | 17,8 | 240 |
| Gemma 4 E2B 💡 🏠 | 29,2 | 5,0 | 6,9 | 5,1 B | 8,5 | 224 |
| Gemma 4 26B A4B 💡 🏠 | 27,9 | 15,6 | 18,6 | 26,0 B (4,0 B actifs) | 50,1 | 118 |
 Qwen3.6 35B A3B 💡 🏠 | 26,6 | 22,1 | 24,8 | 35,0 B (3,0 B actifs) | 30,6 | 347 |
 Nemotron 3 Nano Omni 30B A3B 💡 🏠 | 25,1 | 26,1 | 27,0 | 30,0 B (3,0 B actifs) | 5,8 | 960 |
| Gemma 4 E4B 💡 🏠 | 22,4 | 6,3 | 10,2 | 8,0 B | 5,7 | 221 |
| Qwen3.6 35B A3B 💡 🏠 | 22,1 | 37,8 | 40,6 | 35,0 B (3,0 B actifs) | 36,9 | 312 |
| Nemotron 3 Nano Omni 30B A3B 💡 🏠 | 21,2 | 35,2 | 36,1 | 30,0 B (3,0 B actifs) | 3,0 | 391 |
| Nemotron 3 Super 120B A12B 💡 🏠 | 21,1 | 86,1 | 87,5 | 120,0 B (12,0 B actifs) | 32,0 | 413 |
| Gemma 4 26B A4B 💡 🏠 | 20,2 | 23,8 | 26,8 | 26,0 B (4,0 B actifs) | 44,1 | 539 |
| Gemma 4 E4B 💡 🏠 | 18,6 | 6,2 | 10,1 | 8,0 B | 10,7 | 218 |
 Granite 4.2 8B 💡 🏠 | 16,9 | 5,3 | 26,8 | 8,0 B | 0,9 | 36 |
| Gemma 4 12B 💡 🏠 | 14,6 | 12,7 | 15,3 | 12,0 B | 43,6 | 124 |
| Gemma 4 12B 💡 🏠 | 11,0 | 7,2 | 9,8 | 12,0 B | 47,5 | 752 |
| Gemma 4 31B 💡 🏠 | 10,0 | 17,7 | 29,6 | 31,0 B | 49,6 | 548 |
| Gemma 4 12B 💡 🏠 | 9,0 | 9,8 | 12,4 | 12,0 B | 24,0 | 216 |
| Qwen3.8 27B 💡 🏠 | 8,9 | 17,7 | 26,5 | 27,0 B | 72,5 | 546 |
 Muse Glimmer 30B 💡 🏠 | 8,8 | 18,2 | 20,0 | 29,6 B | 71,5 | 394 |
| Qwen3.8 27B 💡 🏠 | 8,4 | 30,0 | 38,7 | 27,0 B | 69,7 | 498 |
| Muse Glimmer 30B 💡 🏠 | 8,0 | 21,1 | 22,9 | 29,6 B | 63,5 | 397 |
| Granite 4.2 30B 💡 🏠 | 7,6 | 17,7 | 52,1 | 30,0 B | 3,0 | 423 |
| Qwen3.6 27B 💡 🏠 | 7,5 | 28,6 | 37,3 | 27,0 B | 53,6 | 190 |
| Qwen3.8 27B 💡 🏠 | 7,0 | 23,4 | 32,1 | 27,0 B | 58,0 | 504 |
| Granite 4.2 30B 💡 🏠 | 6,6 | 24,0 | 58,4 | 30,0 B | 9,6 | 397 |
| Gemma 4 31B 💡 🏠 | 5,8 | 26,4 | 38,4 | 31,0 B | 59,7 | 527 |
| Qwen3.6 27B 💡 🏠 | 5,2 | 16,5 | 25,3 | 27,0 B | 45,9 | 588 |
| Granite 4.2 30B 💡 🏠 | 4,9 | 31,1 | 65,5 | 30,0 B | 7,2 | 447 |
| Gemma 4 31B 💡 🏠 | 4,8 | 33,8 | 45,8 | 31,0 B | 42,3 | 316 |
Aucune mesure ne correspond à ces filtres.
Médiane des tokens par seconde sur les réponses valides du benchmark générées sur cette machine, tokens de raisonnement compris ; fichier et mémoire comme sur la page IA locale ; score du classement principal de cette édition. Voir aussi : les mesures publiées par la communauté pour le Ryzen AI Max+ 395.
La règle : la bande passante, pas le calcul
Quand un modèle génère du texte, chaque token exige de lire une fois tous les poids actifs. Sur Strix Halo, la mémoire débite environ 256 Go par seconde : un modèle dense stocké dans 30 Go (Qwen3.8 27B en Q8_0) ne peut pas dépasser 8,5 tokens par seconde environ, et nous mesurons 8,4. Gemma 4 31B Q8_0, 33,8 Go, tombe à 4,8. Diviser le fichier par deux avec une quantification Q4 double à peu près la vitesse, au prix documenté dans notre analyse des quantifications.
Les modèles à mélange d’experts échappent à la règle : ils stockent beaucoup de paramètres mais en activent peu par token. Gemma 4 26B A4B lit 4 milliards de paramètres par token et atteint 40 tokens par seconde en Q8_0 ; Qwen3.6 35B A3B atteint 22 ; Ling 3.0 Flash, un fichier de 77 Go, produit encore 30 tokens par seconde parce que seuls 5 milliards de paramètres travaillent à la fois. Sur ce matériel, le bon compromis pour écrire est un modèle à experts en Q8, pas un modèle dense en Q4.
Ce que les 128 Go achètent vraiment
De la mémoire, pas de la vitesse. Nemotron 3 Super 120B en Q4_K_M est un fichier de 86 Go qu’aucune carte graphique grand public ne peut contenir ; ici il tourne à 21 tokens par seconde. Ling 3.0 Flash, 77 Go, se charge avec de la marge pour un long contexte. Un modèle dense de 70 milliards de paramètres en Q4 tient aussi, mais à 5 tokens par seconde environ, c’est un outil pour rédacteur patient. Les benchmarks communautaires donnent au M4 Max d’Apple environ deux fois la vitesse de Strix Halo sur ces modèles denses de 70B, pour 1 800 à 2 200 dollars de plus ; sur les modèles à experts, l’écart est bien plus faible.
Comment les chiffres ont été mesurés
Le moteur llama.cpp de LM Studio, réglages par défaut, les mêmes 240 consignes par langue que le reste du Baromètre, raisonnement activé quand le modèle le permet. La médiane porte sur des réponses complètes : elle inclut donc la phase de raisonnement et le traitement de la consigne ; une consigne courte suivie d’un long raisonnement tire le chiffre vers le bas, ce qui correspond à ce qu’un rédacteur vit réellement. Les vitesses varient avec la longueur du contexte, le backend (Vulkan ou ROCm) et les versions de pilotes : lisez-les comme un classement des modèles entre eux sur une machine, pas comme une promesse absolue. La qualité vient du classement des IA locales, qui utilise les mêmes fichiers.
Sources et lectures
- AMD Strix Halo backend benchmarks (llama.cpp sur ROCm et Vulkan, de nombreux modèles)
- Communauté Framework : tests de performance LLM du Ryzen AI Max+ 395
- Level1Techs : résultats de benchmarks LLM sur Strix Halo