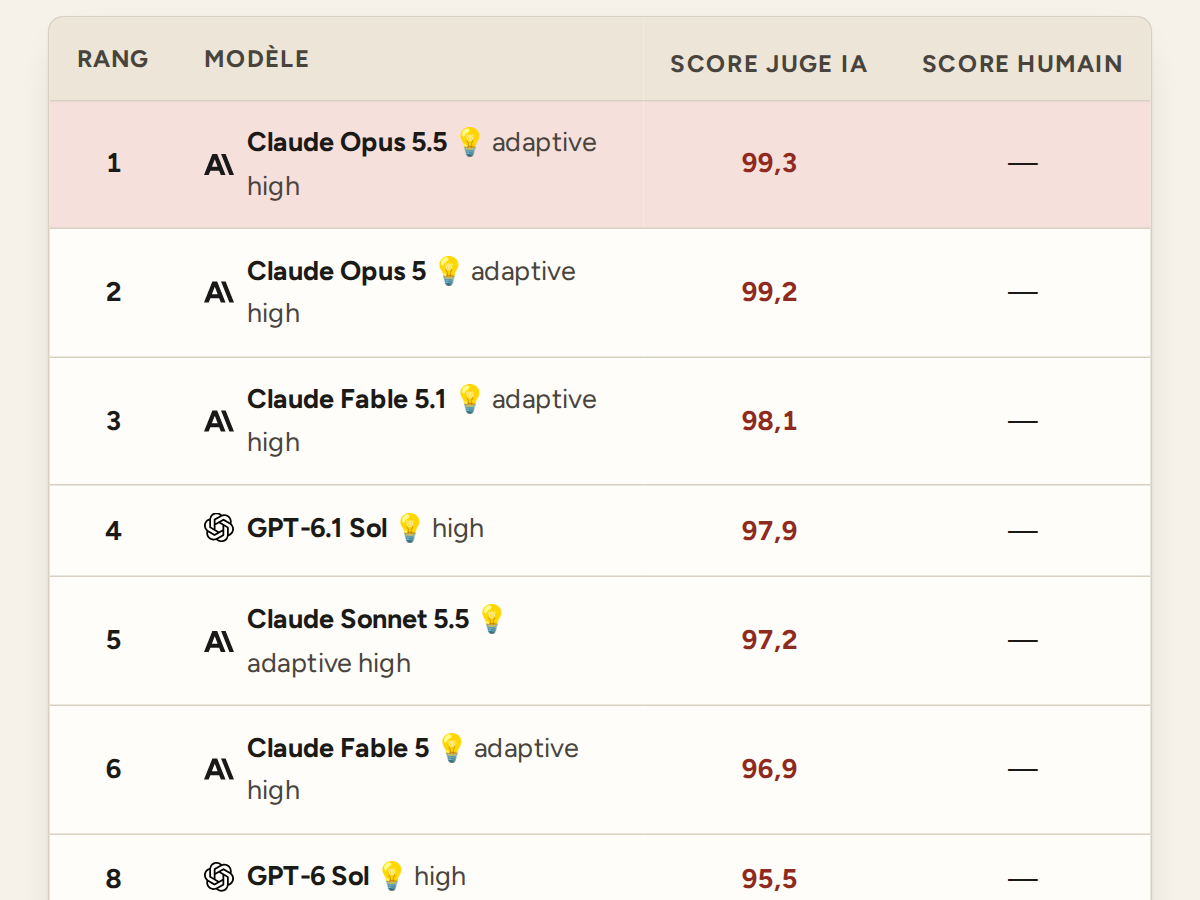
Le classement complet
Tous les modèles classés sur l’écriture en français, avec des filtres par type de texte, éditeur, taille, raisonnement et quantification, et les matrices de duels.
Les nouveaux modèles à leur entrée dans le classement, leur place face à leur prédécesseur, les nouvelles analyses et les grandes étapes du Baromètre.
101 185 verdicts classés
107 modèles classés
encore 23 815 avant 125 000
Totaux cumulés de l’édition française, jour par jour.
Rangs et scores sont ceux d’aujourd’hui : ils sont recalculés à chaque nouveau verdict, pas figés à l’arrivée du modèle.

MiniMax M3.1 Flash. Aujourd’hui 105e sur 107, avec un score de 2,4.
100 000
Atteint 86 jours après le premier duel, 16 jours après le palier de 75 000.

Ling 3.1 Flash. Aujourd’hui 22e sur 107, avec un score de 82,4.

Mistral Large 4. Aujourd’hui 46e sur 107, avec un score de 57,7.
Nemotron 3 Ultra. Aujourd’hui 43e sur 107, avec un score de 61,4.
Nemotron 3.5 Lightning. Aujourd’hui 83e sur 107, avec un score de 18,0.

Claude Haiku 5.5. Aujourd’hui 20e sur 107, avec un score de 83,6.
Jusqu’ici, la plupart des duels comparaient des messages personnels. Les nouveaux duels se répartissent entre les dix catégories (lettres, articles, fiction, discours, rapports…), en commençant par les moins couvertes : le classement reflétera peu à peu tous les types de textes.
Muse Spark 1.3, qui reculait au classement, ne juge plus ; ses verdicts passés restent publiés. Claude Opus 5.5 reprend sa part, et les duels arrivent au même rythme.
Dans le Duel et les face-à-face, les réponses montrent désormais leurs passages en gras, leurs intertitres et leurs listes au lieu d’astérisques et de dièses bruts : on juge le texte tel qu’un lecteur le verrait.
Environ un verdict sur vingt venait d’un juge face à son propre modèle, qui avait tendance à se favoriser : jusqu’à cinq points pour certains modèles. Ces verdicts restent publiés sur la page des juges mais n’entrent plus dans le classement, et aucun juge ne reçoit plus son propre modèle.

GPT-6.1 Sol. Aujourd’hui 3e sur 107, avec un score de 97,8. Soit 1,8 point de plus que son prédécesseur, GPT-6 Sol (8e, 96,0). Duels directs remportés contre lui : 16 sur 21 (76 %).
100
Avec Aion 3.5, 73 jours après le premier duel.

Aion 3.5. Aujourd’hui 21e sur 107, avec un score de 83,4. Soit 27,9 points de plus que son prédécesseur, Aion 3.0 (47e, 55,5).
Claude Sonnet 5.5. Aujourd’hui 6e sur 107, avec un score de 96,7. Soit 5,8 points de plus que son prédécesseur, Claude Sonnet 5 (13e, 90,9).
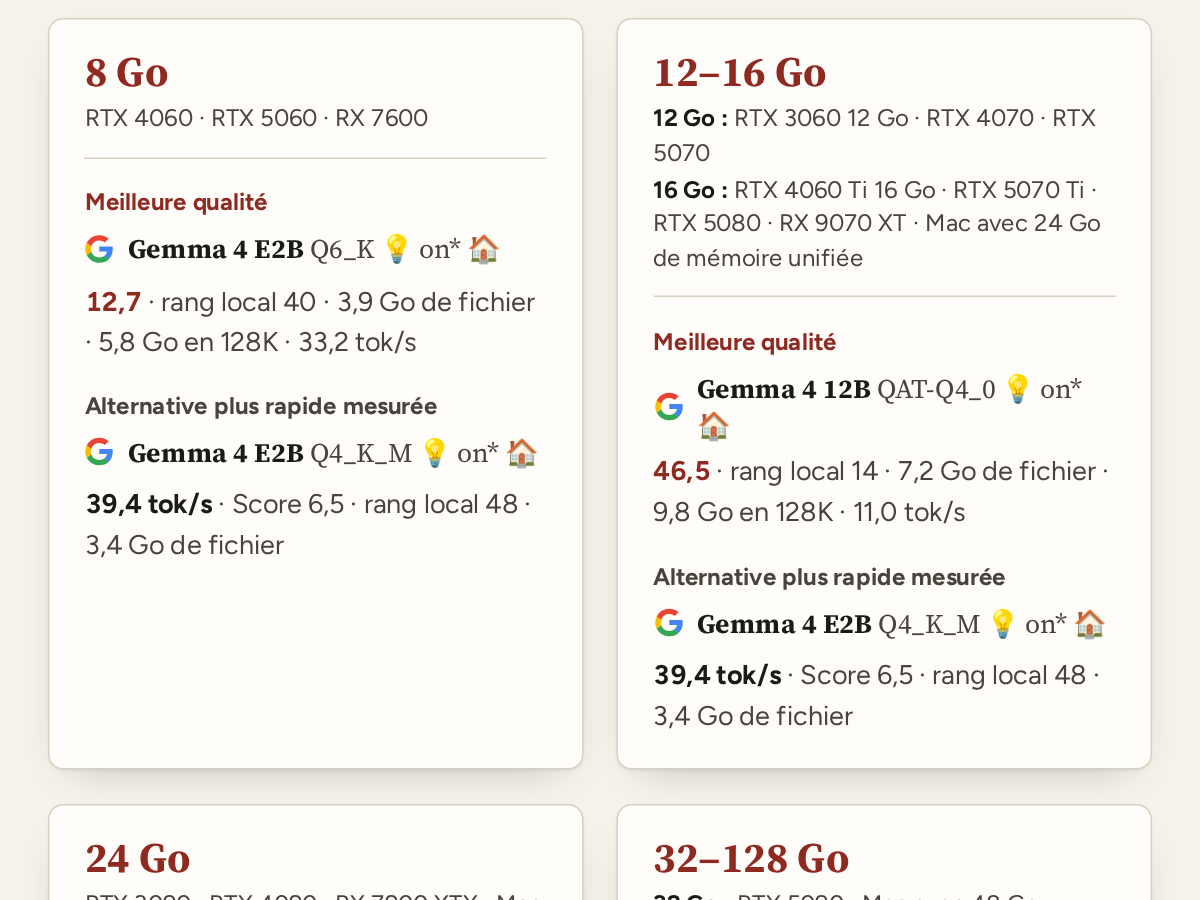
Le classement des IA locales indique la mémoire nécessaire pour le fichier et pour un contexte de 128K ou 256K, en GGUF ou en MLX, avec un cache F16 ou Q8. Des boutons au-dessus de chaque classement passent des derniers modèles à la génération précédente ou aux plus anciens.
75 000
Atteint 70 jours après le premier duel, 12 jours après le palier de 50 000.
Claude Opus 5.5. Aujourd’hui 2e sur 107, avec un score de 98,4. Soit 0,8 point de moins que son prédécesseur, Claude Opus 5 (1er, 99,2).
GPT-6 Luna. Aujourd’hui 16e sur 107, avec un score de 85,9. Soit 8,1 points de plus que son prédécesseur, GPT-5.6 Luna (23e, 77,8).
GPT-6 Sol. Aujourd’hui 8e sur 107, avec un score de 96,0. Soit 8,8 points de plus que son prédécesseur, GPT-5.6 Sol (15e, 87,2).
Les derniers modèles d’Anthropic et d’OpenAI prennent le relais comme juges, aux côtés de Muse Spark 1.3. Chaque verdict compare toujours deux textes anonymes écrits pour la même consigne.

Agnes 3.0 Flash. Aujourd’hui 59e sur 107, avec un score de 46,4.

Grok 4.7. Aujourd’hui 11e sur 107, avec un score de 91,4. Soit 54,6 points de plus que son prédécesseur, Grok 4.6 (70e, 36,8). Duels directs remportés contre lui : 10 sur 11 (91 %).

MiMo V2.6 Flash. Aujourd’hui 68e sur 107, avec un score de 37,8.
MiMo V2.6 Pro. Aujourd’hui 25e sur 107, avec un score de 76,3. Soit 14,3 points de plus que son prédécesseur, MiMo V2.5 Pro (42e, 62,0). Duels directs remportés contre lui : 22 sur 34 (65 %).
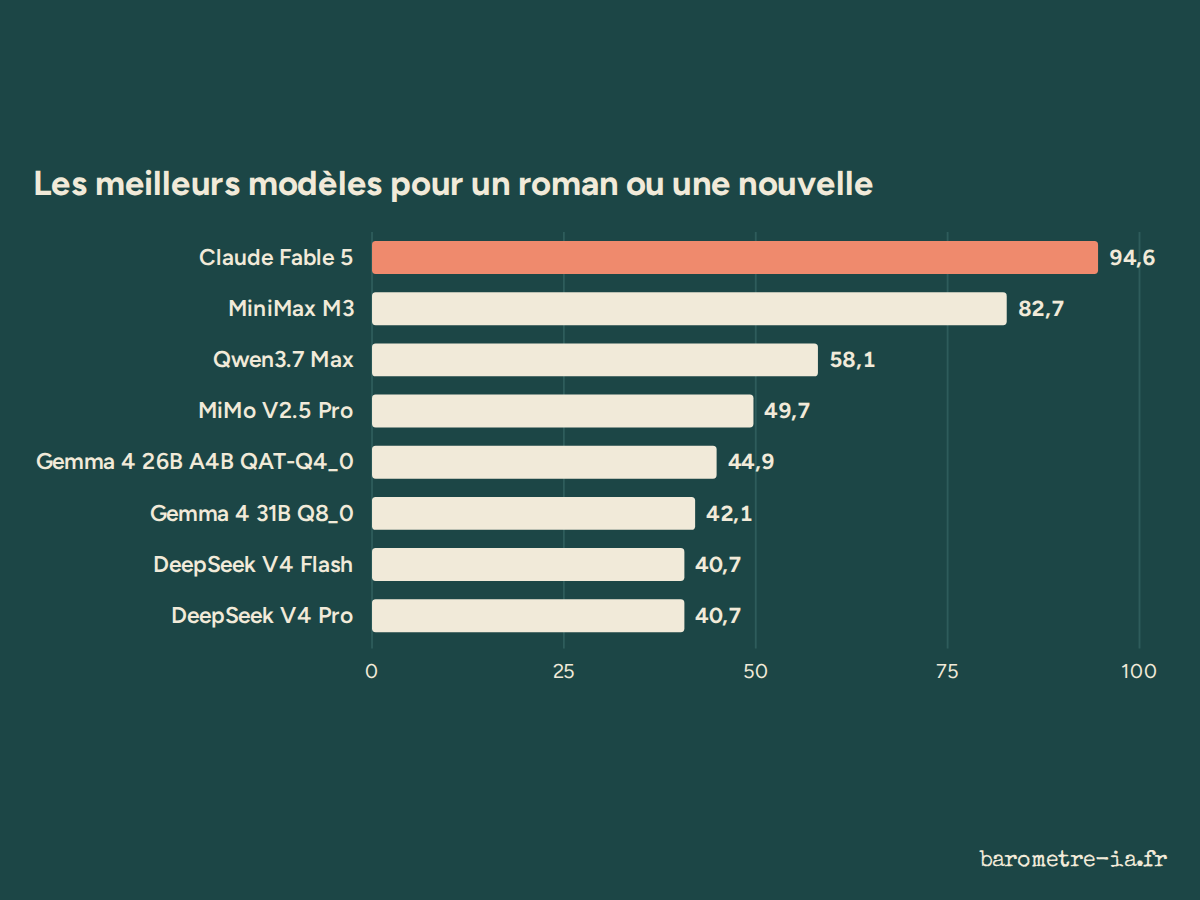 Quelle IA pour un roman, un e-mail, une lettre de motivation ou une dissertation ? Le meilleur modèle change avec le texte
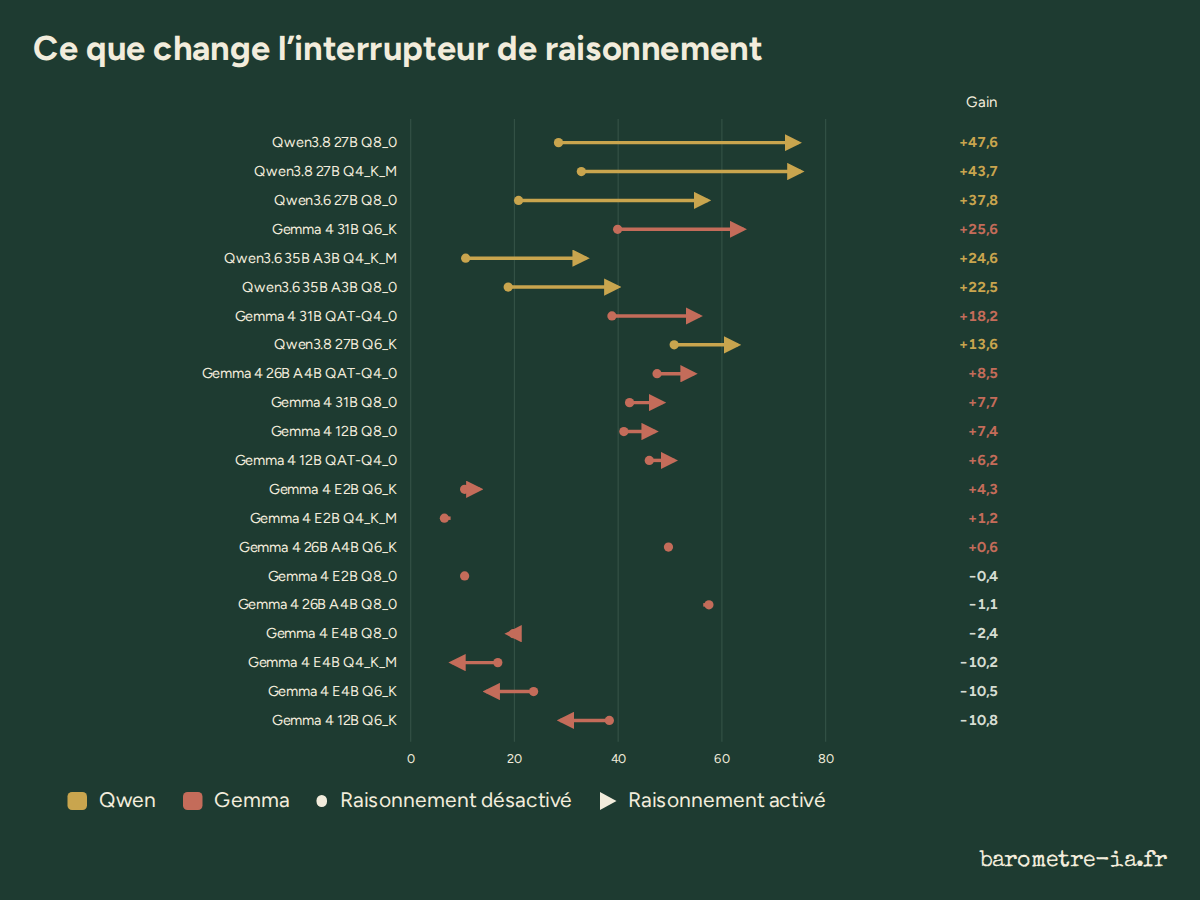
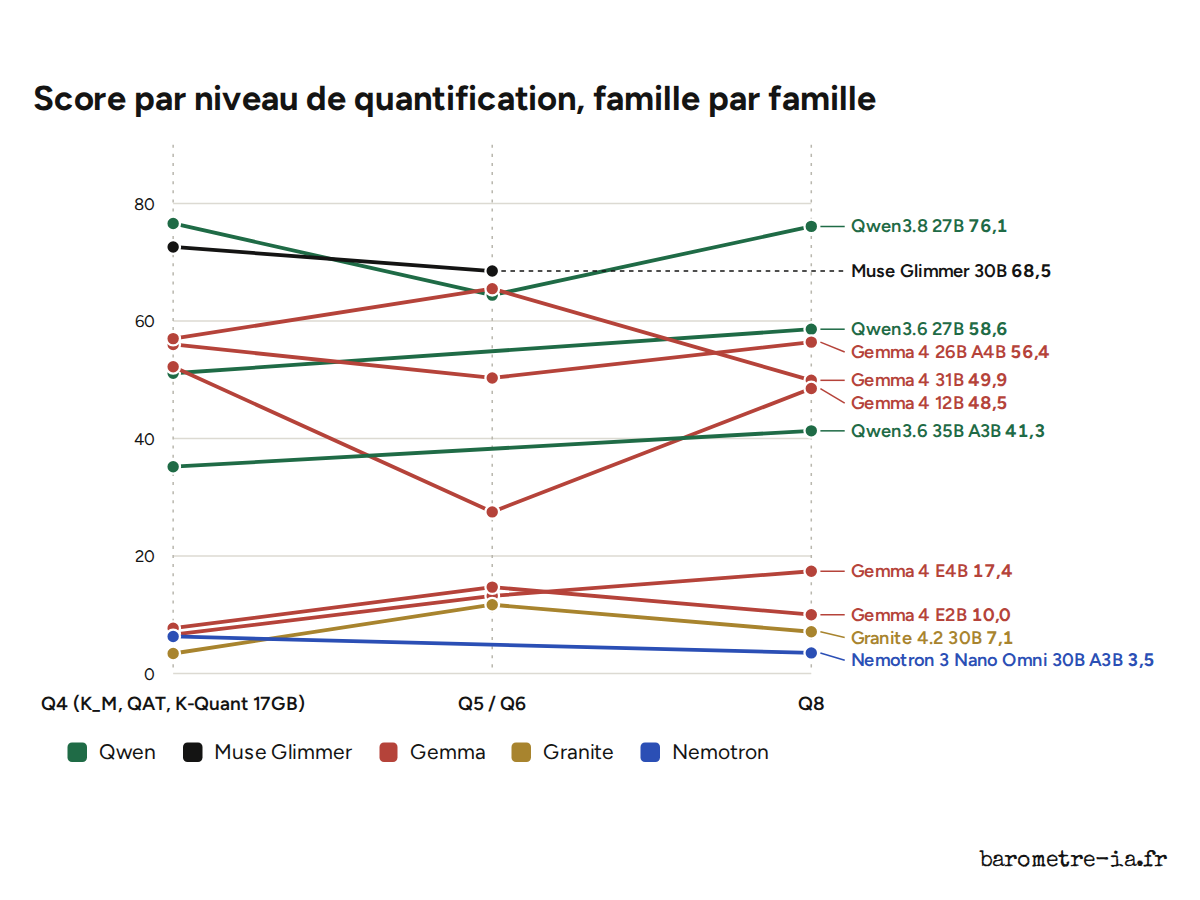 Q4, Q6 ou Q8 : la quantification ne coûte rien sur certains modèles et douze points sur d’autres
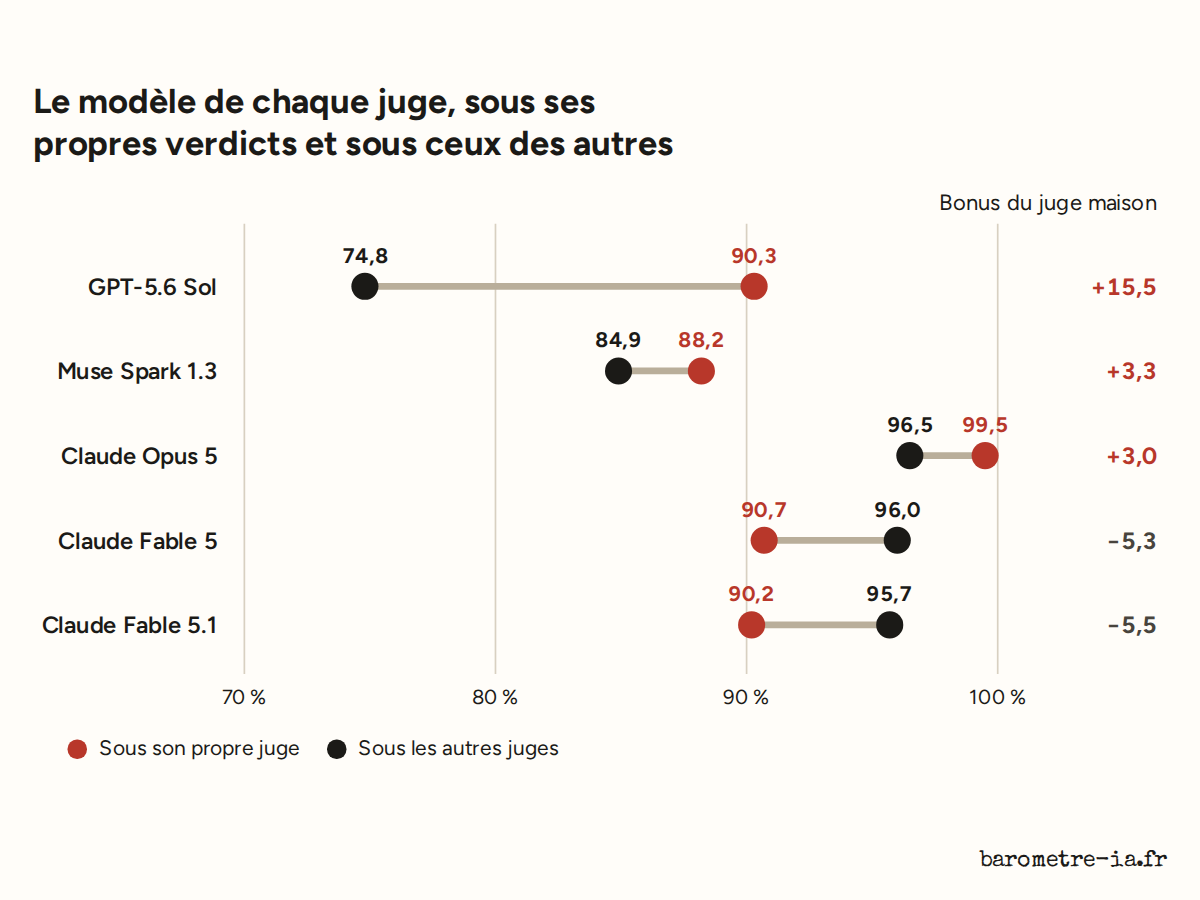 Les juges IA se favorisent-ils ? Deux sur cinq, jusqu’à 16 points d’écart
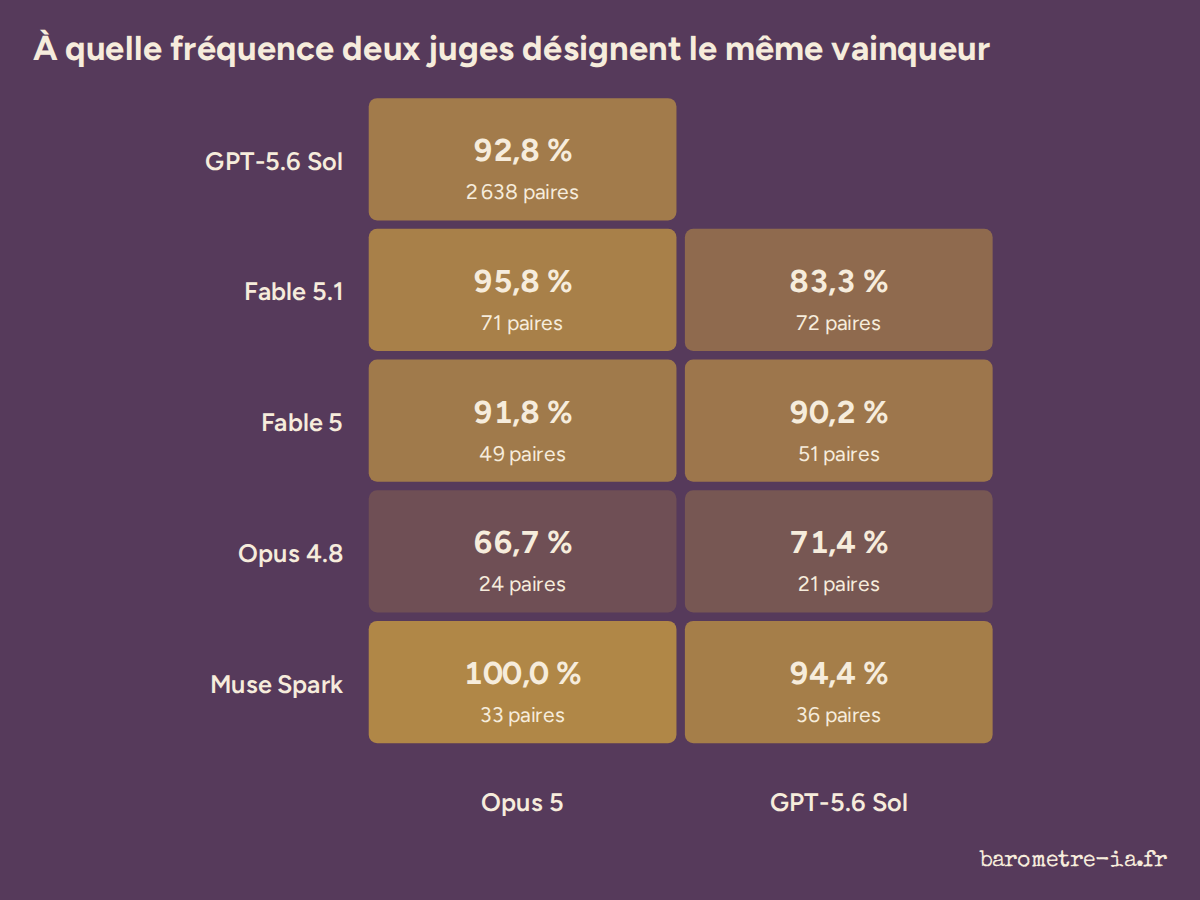 Les deux grands juges IA désignent le même vainqueur neuf fois sur dix. Les désaccords sont ailleurs
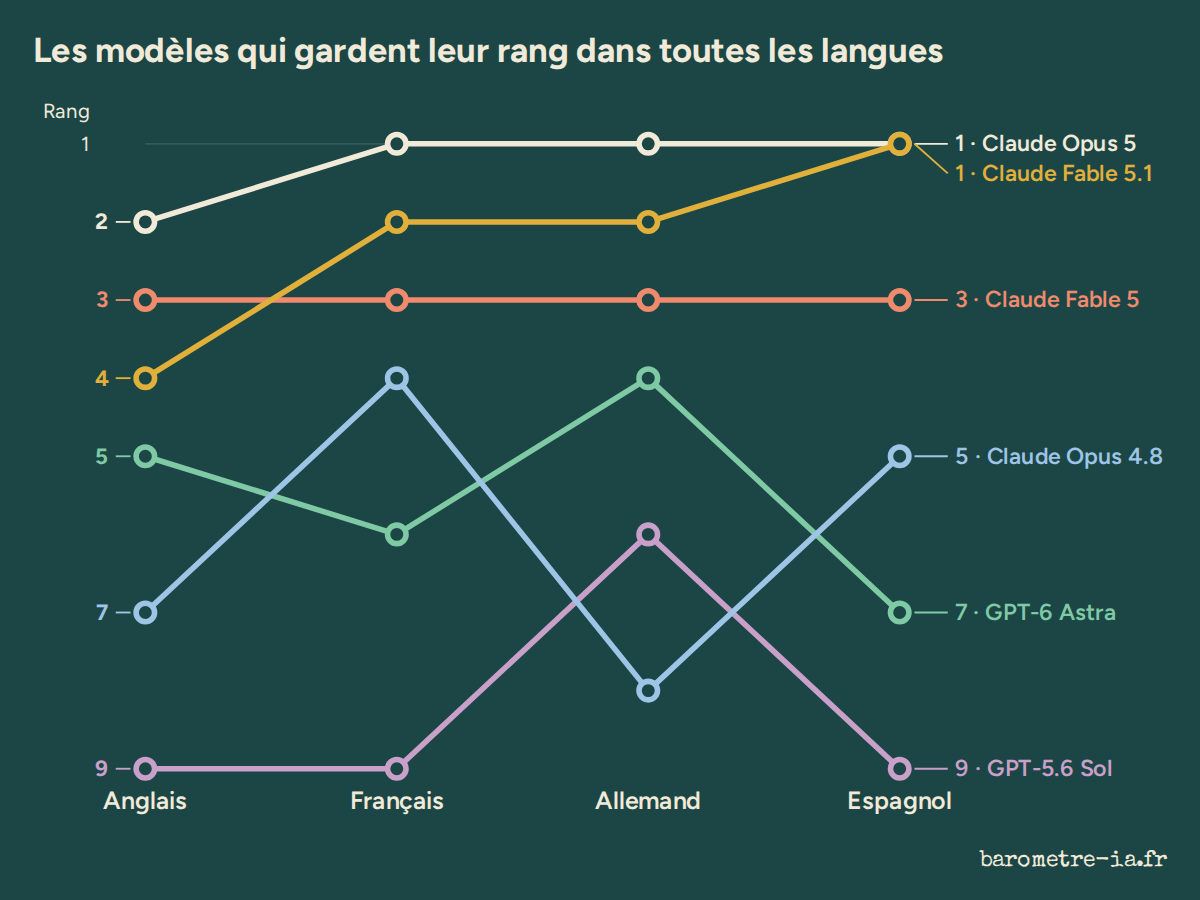 Même modèle, quatre langues : les six premiers ne bougent pas, le milieu de tableau se déplace de quarante places
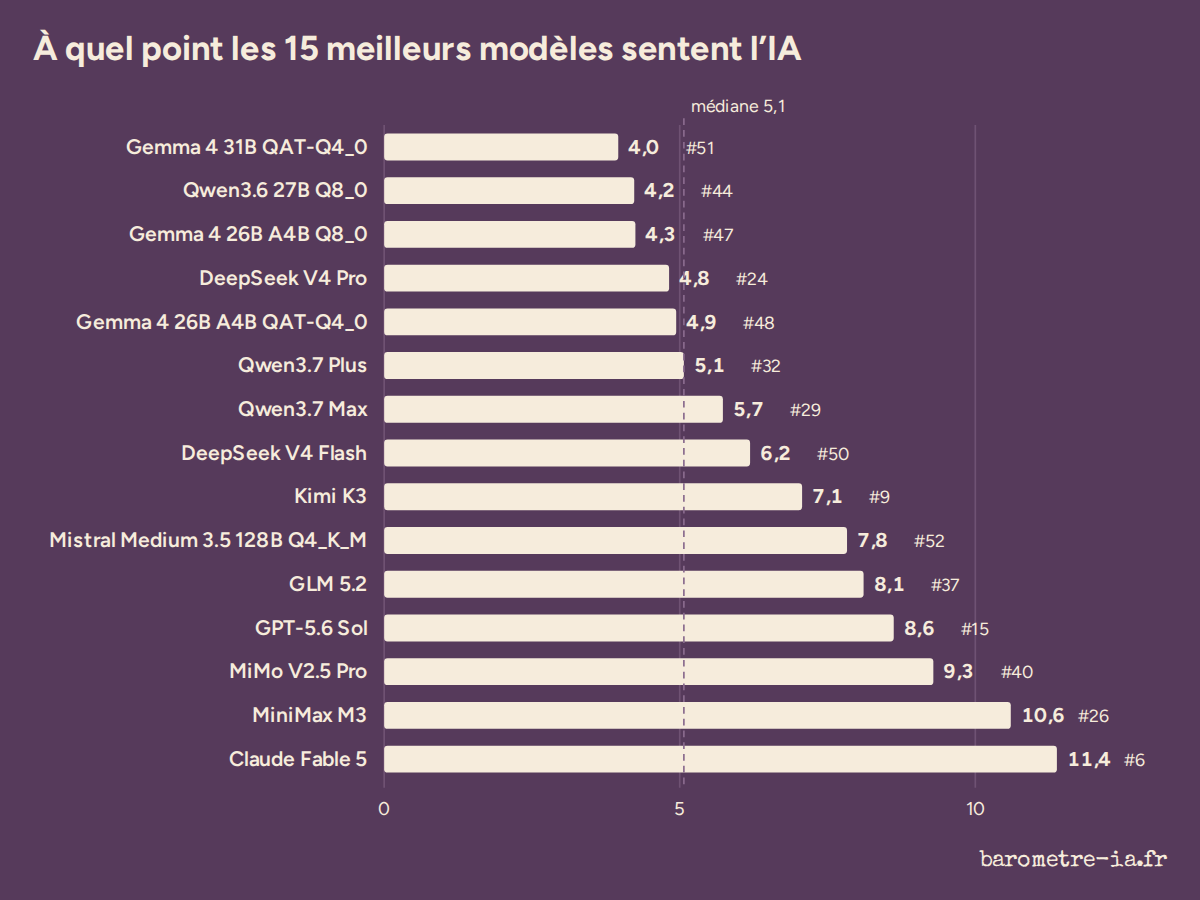 Quelle IA sent le moins l’IA ? « Véritable », les tirets cadratins et les meilleurs modèles
Claude ou ChatGPT, Claude ou Gemini, Gemma ou Qwen : les duels les plus recherchés ont désormais leur page, avec le verdict des duels à l’aveugle. Chaque modèle classé reçoit aussi un indice des tics de la prose machine : formules toutes faites, tirets cadratins, énumérations par trois.
Ling 3.0 Flash. Aujourd’hui 49e sur 107, avec un score de 53,0. Meilleure de ses 2 variantes classées : Ling 3.0 Flash d’InclusionAI (Q4_K_M, raisonnement high).
50 000
Atteint 58 jours après le premier duel, 21 jours après le palier de 25 000.

DeepSeek V4.1 Flash. Aujourd’hui 18e sur 107, avec un score de 85,7. Soit 36,0 points de plus que son prédécesseur, DeepSeek V4 Flash (54e, 49,7).
GPT-6 Astra. Aujourd’hui 9e sur 107, avec un score de 95,7.
Claude Fable 5.1. Aujourd’hui 3e sur 107, avec un score de 97,8. Soit 0,9 point de plus que son prédécesseur, Claude Fable 5 (5e, 96,9).

Gemini 3.8 Flash. Aujourd’hui 17e sur 107, avec un score de 85,8. Soit 13,0 points de plus que son prédécesseur, Gemini 3.6 Flash (29e, 72,8).

Muse Spark 1.3. Aujourd’hui 12e sur 107, avec un score de 91,3. Soit 6,0 points de plus que son prédécesseur, Muse Spark 1.2 (19e, 85,3).
Inkling. Aujourd’hui 40e sur 107, avec un score de 63,9.

Granite 4.2 8B. Aujourd’hui 106e sur 107, avec un score de 1,4. Meilleure de ses 2 variantes classées : Granite 4.2 8B d’IBM (Q8_0, raisonnement full).

GLM 5.3 Flash. Aujourd’hui 37e sur 107, avec un score de 68,7.
Granite 4.2 30B. Aujourd’hui 92e sur 107, avec un score de 9,6. Meilleure de ses 3 variantes classées : Granite 4.2 30B d’IBM (Q6_K, raisonnement full).

Hy4 Preview. Aujourd’hui 34e sur 107, avec un score de 69,9. Soit 18,9 points de plus que son prédécesseur, Hy3 (51e, 51,0). Duels directs remportés contre lui : 15 sur 23 (65 %).

Qwen3.8 Flash. Aujourd’hui 33e sur 107, avec un score de 70,2.
25 000
Atteint 37 jours après le premier duel.
75
Avec Seed 2.1 Turbo, 34 jours après le premier duel.
Aion 3.0. Aujourd’hui 47e sur 107, avec un score de 55,5.
GLM 5.3. Aujourd’hui 14e sur 107, avec un score de 90,1. Soit 25,8 points de plus que son prédécesseur, GLM 5.2 (38e, 64,3). Duels directs remportés contre lui : 21 sur 23 (91 %).
Grok 4.6. Aujourd’hui 70e sur 107, avec un score de 36,8.
Hy3. Aujourd’hui 51e sur 107, avec un score de 51,0.
Mistral Medium 3.5. Aujourd’hui 75e sur 107, avec un score de 32,1.
Muse Spark 1.2. Aujourd’hui 19e sur 107, avec un score de 85,3.
Qwen3.8 Max. Aujourd’hui 26e sur 107, avec un score de 74,2. Soit 2,1 points de plus que son prédécesseur, Qwen3.7 Max (31e, 72,1).

Seed 2.1 Turbo. Aujourd’hui 39e sur 107, avec un score de 64,1.
Qwen3.8 27B. Aujourd’hui 30e sur 107, avec un score de 72,5. Meilleure de ses 6 variantes classées : Qwen3.8 27B d’Alibaba (Q4_K_M, raisonnement xhigh). Soit 18,9 points de plus que son prédécesseur, Qwen3.6 27B (48e, 53,6).
50
Avec Gemma 4 12B, 28 jours après le premier duel.
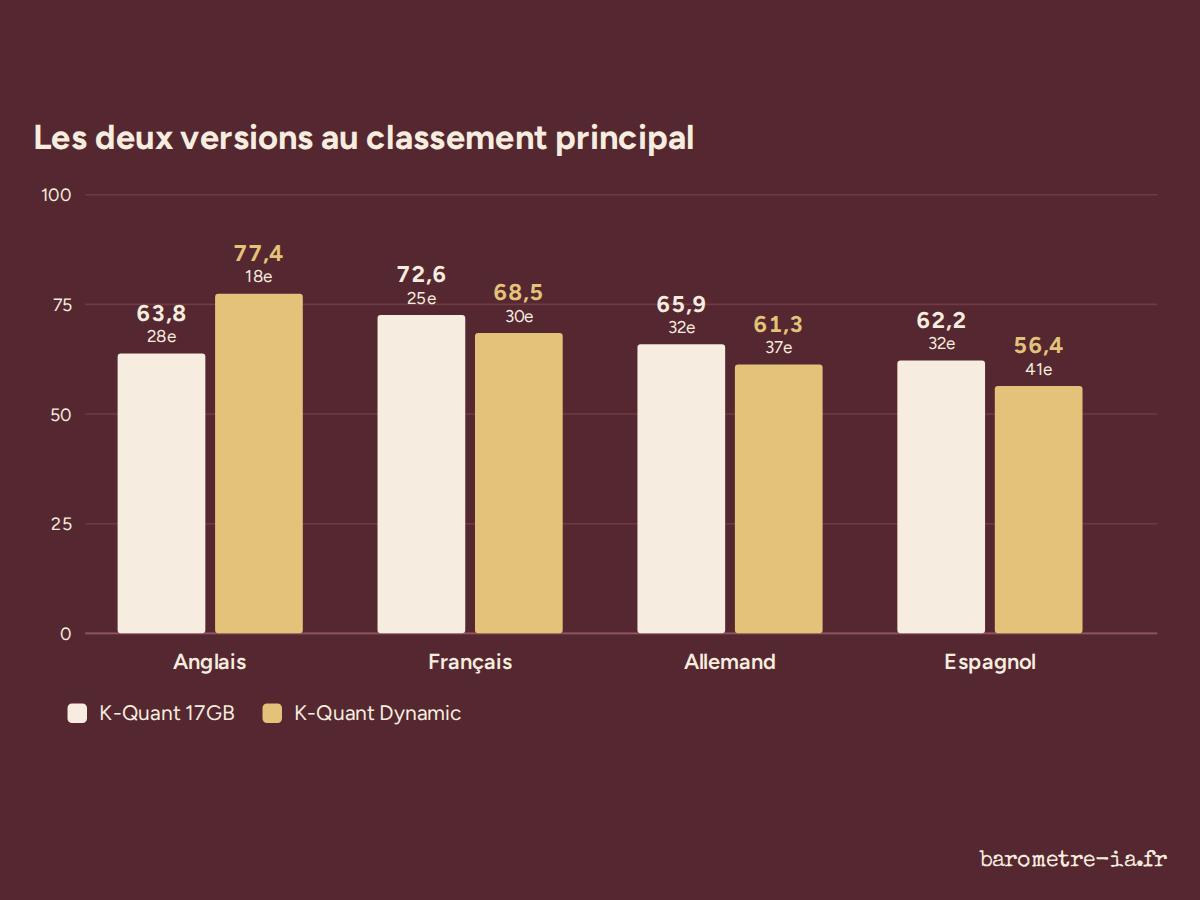
Muse Glimmer 30B. Aujourd’hui 32e sur 107, avec un score de 71,5. Meilleure de ses 2 variantes classées : Muse Glimmer 30B de Meta (K-Quant 17GB, raisonnement high).
Gemma 4 E2B. Aujourd’hui 90e sur 107, avec un score de 12,9. Meilleure de ses 6 variantes classées : Gemma 4 E2B de Google (Q6_K, raisonnement activé).
Gemma 4 E4B. Aujourd’hui 82e sur 107, avec un score de 21,1. Meilleure de ses 6 variantes classées : Gemma 4 E4B de Google (Q6_K, sans raisonnement).
Nemotron 3 Super 120B A12B. Aujourd’hui 76e sur 107, avec un score de 32,0.

Laguna S 2.1 UD. Aujourd’hui 102e sur 107, avec un score de 4,1.
Nemotron 3 Nano Omni 30B A3B. Aujourd’hui 99e sur 107, avec un score de 5,8. Meilleure de ses 2 variantes classées : Nemotron 3 Nano Omni 30B A3B de NVIDIA (Q4_K_M, raisonnement activé).
Claude Sonnet 5. Aujourd’hui 13e sur 107, avec un score de 90,9.
Gemini 3.6 Flash. Aujourd’hui 29e sur 107, avec un score de 72,8.
Claude Opus 5. Aujourd’hui 1er sur 107, avec un score de 99,2. Soit 3,0 points de plus que son prédécesseur, Claude Opus 4.8 (7e, 96,2).
GPT-5.6 Luna. Aujourd’hui 23e sur 107, avec un score de 77,8.
Kimi K3. Aujourd’hui 10e sur 107, avec un score de 94,2.
25
Avec Claude Fable 5, 7 jours après le premier duel.
Claude Fable 5. Aujourd’hui 5e sur 107, avec un score de 96,9.
GPT-5.6 Sol. Aujourd’hui 15e sur 107, avec un score de 87,2.
Claude Opus 4.8. Aujourd’hui 7e sur 107, avec un score de 96,2.
GPT-5.6 Terra. Aujourd’hui 24e sur 107, avec un score de 77,7.
MiniMax M3. Aujourd’hui 28e sur 107, avec un score de 73,0.
DeepSeek V4 Pro. Aujourd’hui 27e sur 107, avec un score de 73,4. Meilleure de ses 2 variantes classées : DeepSeek V4 Pro de DeepSeek (raisonnement activé).
Gemma 4 12B. Aujourd’hui 58e sur 107, avec un score de 47,5. Meilleure de ses 6 variantes classées : Gemma 4 12B de Google (QAT-Q4_0, raisonnement activé).
Gemma 4 26B A4B. Aujourd’hui 50e sur 107, avec un score de 52,5. Meilleure de ses 6 variantes classées : Gemma 4 26B A4B de Google (Q8_0, sans raisonnement).
Gemma 4 31B. Aujourd’hui 44e sur 107, avec un score de 59,7. Meilleure de ses 6 variantes classées : Gemma 4 31B de Google (Q6_K, raisonnement activé).
GLM 5.2. Aujourd’hui 38e sur 107, avec un score de 64,3.
MiMo V2.5 Pro. Aujourd’hui 42e sur 107, avec un score de 62,0. Meilleure de ses 2 variantes classées : MiMo V2.5 Pro de Xiaomi (raisonnement activé).
Mistral Medium 3.5 128B. Aujourd’hui 55e sur 107, avec un score de 49,6.
Qwen3.6 27B. Aujourd’hui 48e sur 107, avec un score de 53,6. Meilleure de ses 3 variantes classées : Qwen3.6 27B d’Alibaba (Q8_0, raisonnement activé).
Qwen3.6 35B A3B. Aujourd’hui 69e sur 107, avec un score de 36,9. Meilleure de ses 4 variantes classées : Qwen3.6 35B A3B d’Alibaba (Q8_0, raisonnement activé).
Qwen3.7 Max. Aujourd’hui 31e sur 107, avec un score de 72,1. Meilleure de ses 2 variantes classées : Qwen3.7 Max d’Alibaba (raisonnement activé).
Tous les modèles classés sur l’écriture en français, avec des filtres par type de texte, éditeur, taille, raisonnement et quantification, et les matrices de duels.
Le classement vivant des modèles à poids ouverts pour écrire en français, la mémoire que demande chaque fichier et ce qui tient dans 16, 24, 32 ou 128 Go.
Des articles fondés sur les données : les juges, la quantification, le raisonnement et les quatre langues.