Les juges IA se favorisent-ils ? Deux sur cinq, jusqu’à 16 points d’écart
Quand GPT-5.6 Sol juge un duel où figure GPT-5.6 Sol, ses propres textes récoltent 90 % des points ; sous les autres juges, 75 %. Claude Opus 5 penche du même côté, plus légèrement. Les deux juges Claude Fable font l’inverse et se notent plus sévèrement que les autres.
Mise à jour du 1er octobre 2026. Depuis le 23 septembre, Claude Opus 5.5 et GPT-6 Sol ont remplacé Claude Opus 5 et GPT-5.6 Sol, et ils jugent eux aussi des paires où figure leur propre modèle. Même méthode, données au 1er octobre : Claude Opus 5.5 accorde à son modèle 99,5 % des points sur 606 duels auto-jugés, contre 98,0 % sous les autres juges (874 duels) ; GPT-6 Sol s’accorde 95,6 % sur 436 duels, contre 91,0 % sous les autres (1 041 duels) ; Muse Spark 1.3, juge depuis le 8 septembre, s’accorde 85,1 % sur 251 duels, contre 84,1 % sous les autres (1 847 duels). Les trois juges actuels penchent donc du côté de leur modèle, de 1 à 5 points, loin des 16 points de GPT-5.6 Sol. Pour Opus 5.5 et GPT-6 Sol, « les autres juges » se résument aux deux autres juges actifs, qui ne couvrent pas les mêmes tranches du classement : ces écarts restent des indications. Le reste de l’article et ses graphiques portent sur les données du 19 septembre 2026.
Chaque juge de ce baromètre reçoit deux textes anonymes et désigne le meilleur. Anonymes pour le juge, pas pour nous : nous savons qui a écrit chaque texte. On peut donc poser une question que le juge ne peut pas se poser : quand l’un des deux textes vient de son propre modèle, le verdict change-t-il ?
Pour deux juges, oui. Le diagramme compare, pour chaque juge, la part des points que son modèle récolte quand ce juge tranche et la part que le même modèle récolte sous tous les autres juges. Une victoire vaut un point, une égalité un demi-point. Données : tous les duels français publiés au 19 septembre 2026, environ 65 000 verdicts.
GPT-5.6 Sol accorde 16 points de plus à ses propres textes, Claude Opus 5 en accorde 3
Le modèle de chaque juge, sous ses propres verdicts et sous ceux des autres
Part des points que le modèle récolte (une victoire vaut 1, une égalité ½) quand son propre modèle juge, et quand les autres juges tranchent.
- Sous son propre juge
- Sous les autres juges
Voir les données en tableau
| Juge | Sous son propre juge | Sous les autres juges | Bonus du juge maison | n |
|---|---|---|---|---|
| GPT-5.6 Sol | 90,3 % | 74,8 % | +15,5 | 1 044 |
| Muse Spark 1.3 | 88,2 % | 84,9 % | +3,3 | 140 |
| Claude Opus 5 | 99,5 % | 96,5 % | +3,0 | 825 |
| Claude Fable 5 | 90,7 % | 96,0 % | −5,3 | 854 |
| Claude Fable 5.1 | 90,2 % | 95,7 % | −5,5 | 193 |
GPT-5.6 Sol est le cas le plus net : 90,3 % des points quand il juge lui-même, 74,8 % quand n’importe qui d’autre juge, sur un millier de duels. Claude Opus 5 penche du même côté mais de peu, 99,5 % contre 96,5 %, et il faut dire qu’à ce niveau il ne reste presque plus de marge. Muse Spark 1.3 suit de loin, 88,2 % contre 84,9 %, sur 140 duels seulement, trop peu pour conclure.
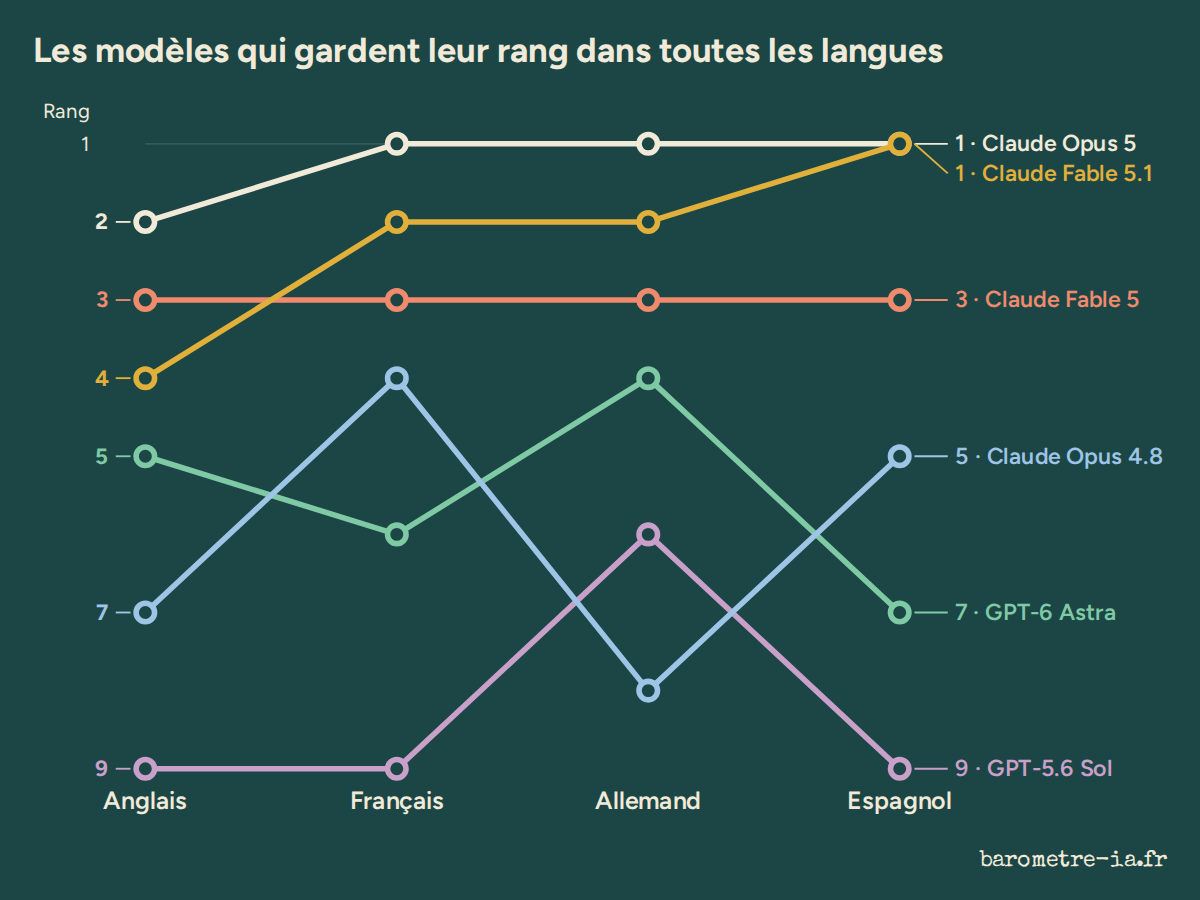
Le même schéma se retrouve en anglais, en allemand et en espagnol, avec un bonus de 15 à 20 points pour Sol à chaque fois. Ce n’est pas un accident du corpus français.
Claude Fable 5 et Claude Fable 5.1 se notent plus sévèrement que les autres
Les deux juges Fable font le chemin inverse. Sous leurs propres verdicts, leurs textes récoltent moins de points que sous les autres juges : 90,7 % contre 96,0 % pour Fable 5, 90,2 % contre 95,7 % pour Fable 5.1. Cinq points de malus, là encore dans les quatre langues. Quelle qu’en soit la raison, ils ne se font pas de cadeau.
Pourquoi ce bonus comptait : deux juges fournissaient 85 % des verdicts
Le bonus d’un juge minoritaire se diluerait dans le classement commun. Ici, impossible : au 19 septembre, Claude Opus 5 et GPT-5.6 Sol produisaient 85 % de tous les verdicts. Environ 800 duels Opus-sur-Opus et 1 000 duels Sol-sur-Sol entrent dans l’ajustement de Bradley–Terry avec tous les autres, et ils pèsent.
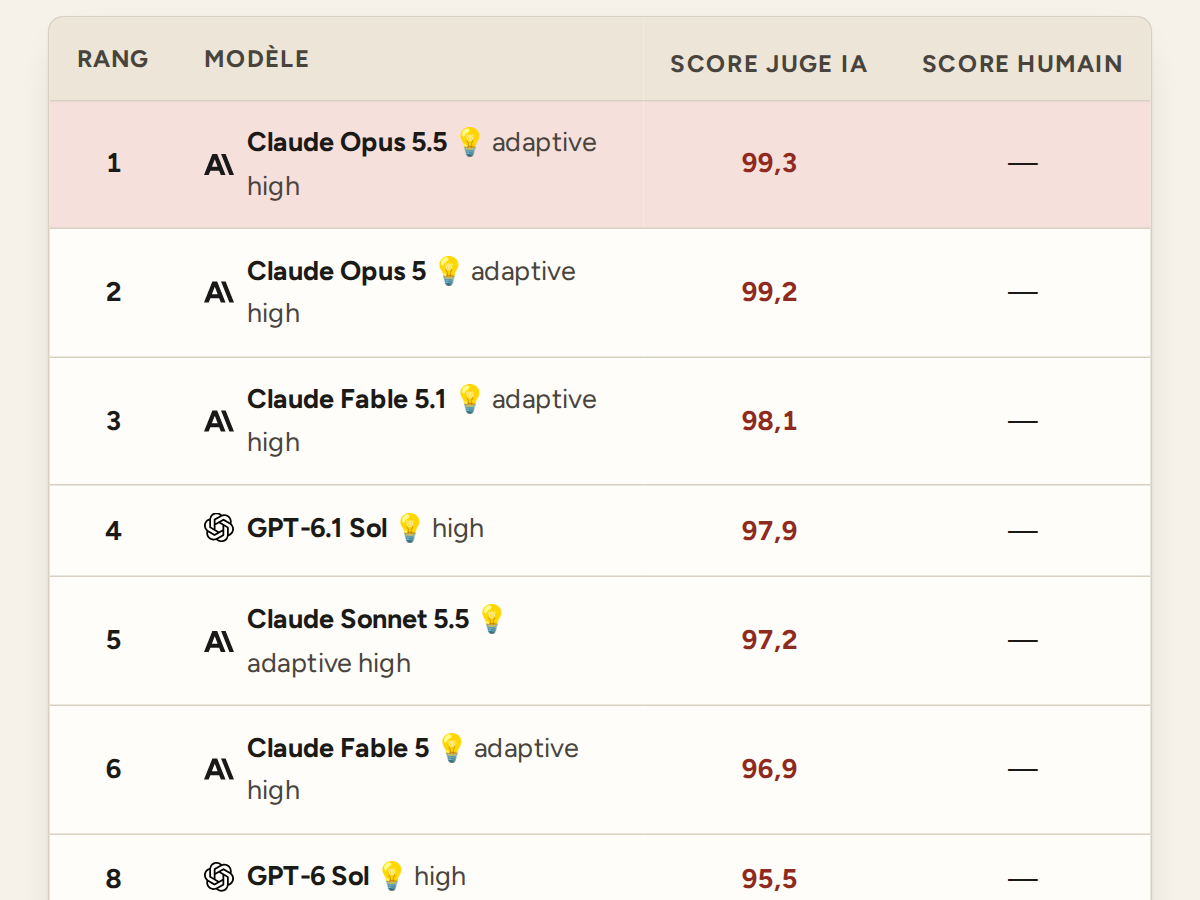
On le voyait dans les tableaux par juge : GPT-5.6 Sol plaçait son propre modèle deuxième quand il jugeait seul, alors que le classement commun le mettait neuvième. Claude Opus 5 était premier partout, seul ou en commun, si bien que son bonus ne changeait rien en tête mais gonflait tout de même son score.
Pourquoi nous ne parlons pas encore de biais
Deux réserves empêchent de conclure. D’abord, les duels ne sont pas les mêmes : sous son propre juge, un modèle rencontre un mélange d’adversaires différent de celui qu’il rencontre sous les autres, et ce mélange modifie la part attendue. L’écart de Sol est trop grand pour s’expliquer entièrement ainsi, mais en partie, oui. Ensuite, « les autres juges » n’est pas un instrument neutre : c’est surtout Opus 5 quand on regarde Sol, et surtout Sol quand on regarde Opus 5. Si l’un est sévère avec l’autre, cette sévérité s’ajoute sur la même ligne.
Le test propre, c’est un échantillon contrôlé, les mêmes paires jugées par tous les juges, et un classement qui exclut les duels auto-jugés. Ni l’un ni l’autre n’est encore publié ; en attendant, la mise à jour en tête d’article suit les juges actuels avec la même méthode.
Conclusion
La préférence de soi existe chez deux juges et pas chez deux autres. Comme Claude Opus 5 et GPT-5.6 Sol fournissaient 85 % des verdicts au 19 septembre, leur bonus pouvait faire gagner quelques places à leurs propres modèles au classement principal. La suite : un classement calculé sans les duels auto-jugés, pour mesurer exactement ce qui bouge.