Même modèle, quatre langues : les six premiers ne bougent pas, le milieu de tableau se déplace de quarante places
Quatre-vingt-onze modèles sont classés en anglais, en français, en allemand et en espagnol selon le même protocole. Au 19 septembre, Claude Fable 5 était troisième dans les quatre langues, Claude Opus 5 premier en français. Plus bas, Grok 4.6 était 25e en anglais et 60e en français, et Qwen3.8 27B le meilleur modèle local en français mais l’un des plus faibles en allemand.
Les quatre éditions de ce baromètre partagent les mêmes modèles, les mêmes juges et le même protocole. Seules les consignes changent : 240 par langue, rédigées directement dans chaque langue. Quand un modèle est 10e en anglais et 54e en allemand, ce n’est donc pas la méthode qui change. C’est le modèle.
Quatre-vingt-onze variantes de modèles ont un score publié dans les quatre langues. Les chiffres cités dans le texte datent du 19 septembre 2026 ; les graphiques sont recalculés à chaque mise à jour et peuvent s’en écarter. Voici jusqu’où ces variantes voyagent.
Les six premiers bougent à peine : au 19 septembre, Claude Fable 5 était troisième partout, Claude Opus 5 premier en français
Les modèles qui gardent leur rang dans toutes les langues
Rang dans chaque édition des six modèles dont le rang bouge le moins d’une langue à l’autre. Le rang 1 est en haut.
Voir les données en tableau
| Modèle | Anglais | Français | Allemand | Espagnol |
|---|---|---|---|---|
| Claude Fable 5 | 3 | 3 | 3 | 3 |
| Claude Opus 5 | 2 | 1 | 1 | 1 |
| Claude Fable 5.1 | 4 | 2 | 2 | 1 |
| GPT-5.6 Sol | 9 | 9 | 6 | 9 |
| GPT-6 Astra | 5 | 6 | 4 | 7 |
| Claude Opus 4.8 | 7 | 4 | 8 | 5 |
Six modèles ne quittent jamais les neuf premières places, quelle que soit la langue : Claude Fable 5, Claude Opus 5, Claude Fable 5.1, GPT-6 Astra, Claude Opus 4.8 et Kimi K3. Kimi K3 est le seul modèle à poids ouverts du lot ; premier en anglais, il était alors cinquième en français. GPT-5.6 Sol complétait le club, neuvième dans trois langues et sixième en allemand.
Les scores racontent la même histoire, avec une nuance : Claude Opus 5 obtient 99,5 en français et 93,7 en anglais. Cela veut dire que le plateau français lui laisse plus de marge pour dominer, pas qu’il écrit mieux le français que l’anglais. Les scores ne se comparent qu’au sein d’une même langue.
Sous la tête, un même modèle peut être 10e dans une langue et 54e dans une autre
Même modèle, quatre rangs
Rang dans chaque édition des six modèles au plus grand écart, parmi les 91 modèles classés dans les quatre langues. Le rang 1 est en haut.
Voir les données en tableau
| Modèle | Anglais | Français | Allemand | Espagnol |
|---|---|---|---|---|
| GLM 5.3 Flash | 10 | 27 | 54 | 44 |
| Qwen3.8 27B Q4_K_M | 27 | 17 | 58 | 54 |
| Ling 3.0 Flash Q4_K_M | 66 | 35 | 76 | 65 |
| Grok 4.6 | 25 | 60 | 52 | 21 |
| Hy3 | 15 | 43 | 25 | 51 |
| Seed 2.1 Turbo ↯ | 57 | 28 | 61 | 43 |
GLM 5.3 Flash est dans les dix premiers en anglais et dans la moitié basse en allemand. Grok 4.6 est solide en anglais et en espagnol, faible en français et en allemand. Hy3 est bon en anglais, médiocre partout ailleurs. Ce ne sont pas des accidents d’échantillonnage : chaque modèle compte entre 1 000 et 1 800 duels classés par langue, et les intervalles de confiance font quelques points de large.
Les modèles locaux suivent le même schéma, avec un détail en plus. Qwen3.8 27B en Q4_K_M était au 19 septembre le meilleur modèle local en français, 17e au général, et l’un des plus faibles en allemand, 58e. Le même fichier, sur la même machine, avec le même réglage de raisonnement. Ce que Qwen a appris du français, il ne l’a pas appris de l’allemand.
Le meilleur modèle local change à chaque langue, et l’écart avec le cloud se creuse en allemand et en espagnol
Meilleur modèle contre meilleur modèle local
Score du leader de chaque édition et de son meilleur modèle exécuté localement. Les scores ne se comparent qu’au sein d’une langue.
- Meilleur modèle
- Meilleur modèle local
Voir les données en tableau
| Meilleur modèle | Meilleur modèle local | |
|---|---|---|
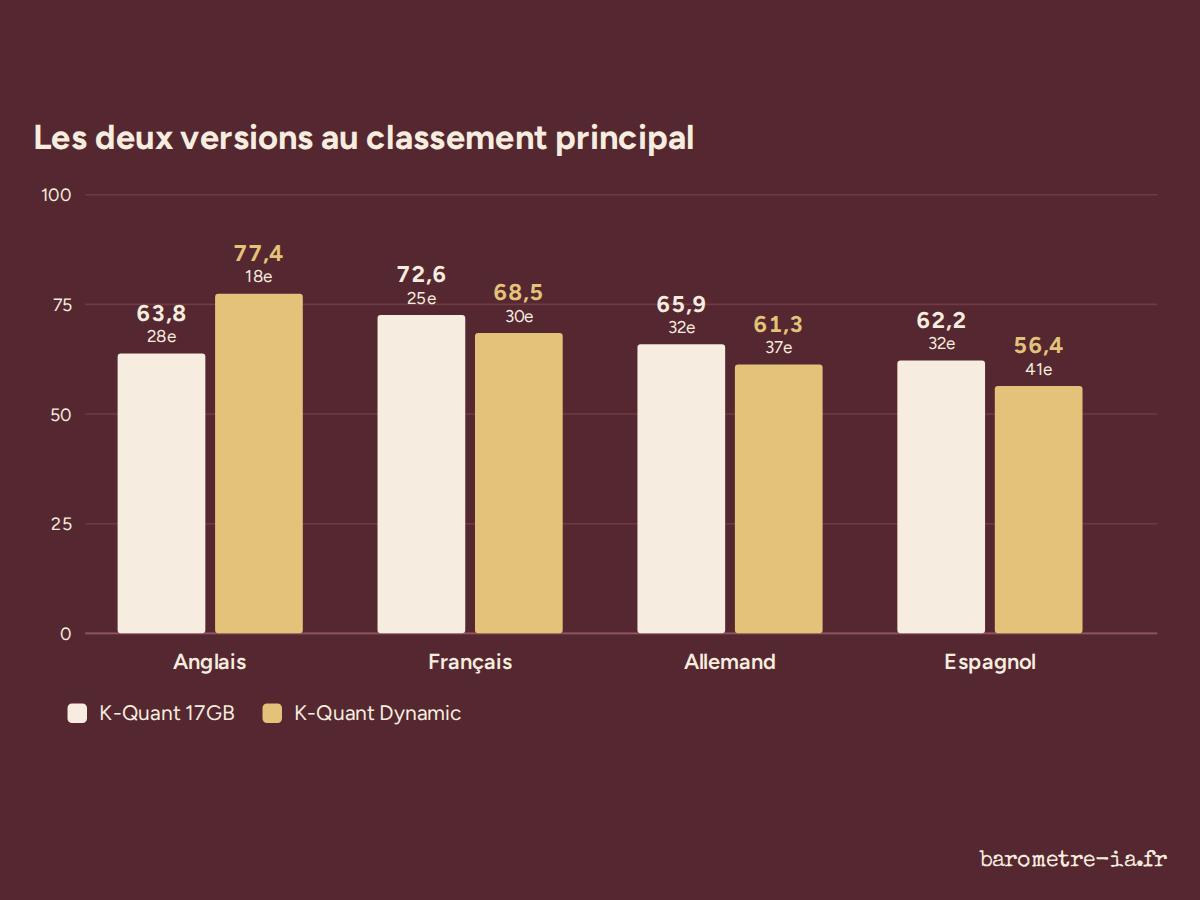
| Anglais | Kimi K3, 93,8 | Muse Glimmer 30B K-Quant Dynamic, 77,4 (18e) |
| Français | Claude Opus 5, 99,5 | Qwen3.8 27B Q4_K_M, 76,6 (17e) |
| Allemand | Claude Opus 5, 98,0 | Gemma 4 31B Q8_0, 72,1 (24e) |
| Espagnol | Claude Fable 5.1, 98,3 | Qwen3.8 27B Q8_0, 70,4 (23e) |
Qwen3.8 27B gagne le peloton local en français et en espagnol, Muse Glimmer 30B en anglais, Gemma 4 31B en allemand. Personne ne le devinerait en ne lisant qu’un classement. En français, 23 points séparent le meilleur modèle local, Qwen3.8 27B Q4_K_M à 76,6, du meilleur modèle cloud, Claude Opus 5 à 99,5 ; c’est 16 points en anglais, 26 à 28 en allemand et en espagnol.
Ce qu’il faut en retenir
Lire un classement anglais pour choisir un modèle qui écrira en français est une erreur pour environ un tiers du peloton. Les modèles fermés de tête sont sûrs dans toutes les langues que nous testons. En dessous, lisez l’édition française, et si vous faites tourner des modèles en local, vérifiez la quantification précise : le fichier qui gagne dans une langue peut perdre dans la suivante.
Conclusion
Les modèles de tête sont en tête dans toutes les langues, le reste du peloton non. Si vous écrivez en français, un classement fait sur de l’anglais vous trompe sur un tiers des modèles : lisez l’édition française, et si vous faites tourner des modèles en local, vérifiez-y la quantification précise.