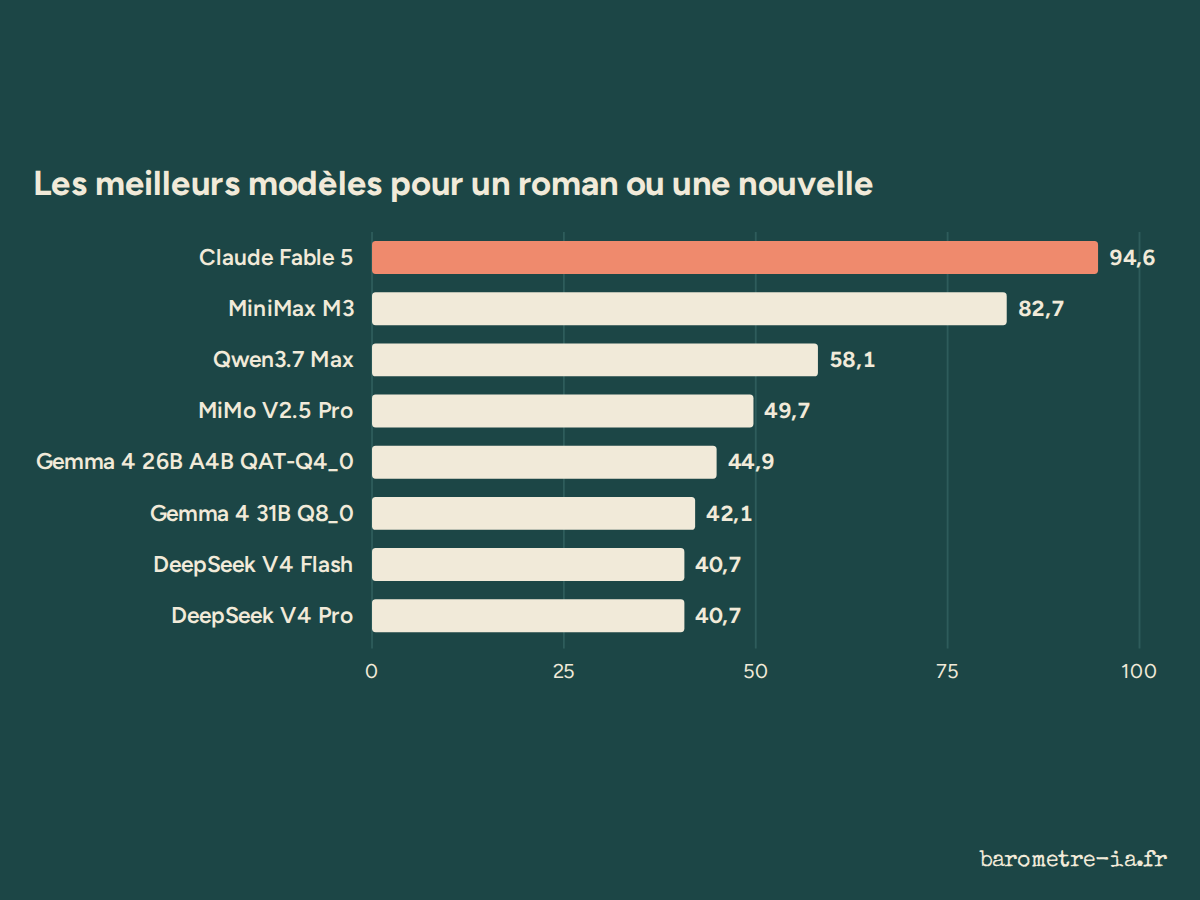
Les modèles sont classés selon la qualité des textes produits en français. Utilisez les filtres pour affiner la liste. Pour les catégories d’écriture sélectionnées, les rangs sont calculés avant les filtres d’éditeur, de taille, d’accès, de raisonnement et de quantification ; les modèles masqués peuvent donc laisser des écarts.
Dernière actualisation :
Classement des modèles d’écriture fondé sur les résultats par paires
Rang
Modèle
Score juge IA
Score humain
1
Claude Opus 5 💡 adaptive high
99,2
—
2
Claude Opus 5.5 💡 adaptive high
98,4
—
3
Claude Fable 5.1 💡 adaptive high
97,8
—
3
GPT-6.1 Sol 💡 high
97,8
—
5
Claude Fable 5 💡 adaptive high
96,9
—
6
Claude Sonnet 5.5 💡 adaptive high
96,7
—
8
GPT-6 Sol 💡 high
96,0
—
9
GPT-6 Astra 💡 high
95,7
—
10
Kimi K3 💡 enabled
94,2
—
11
Grok 4.7 💡 high
91,4
—
12
Muse Spark 1.3 💡 high
91,3
—
13
Claude Sonnet 5 💡 adaptive high
90,9
—
14
GLM 5.3 💡 max
90,1
—
15
GPT-5.6 Sol 💡 high
87,2
—
16
GPT-6 Luna 💡 high
85,9
—
17
Gemini 3.8 Flash 💡 high
85,8
—
18
DeepSeek V4.1 Flash 💡 high
85,7
—
19
Muse Spark 1.2 💡 high
85,3
—
20
Claude Haiku 5.5 💡 adaptive high
83,6
—
21
Aion 3.5 💡 high
83,4
—
22
Ling 3.1 Flash 💡 high
82,4
—
23
GPT-5.6 Luna 💡 high
77,8
—
24
GPT-5.6 Terra 💡 high
77,7
—
25
MiMo V2.6 Pro fp8 💡 high
76,3
—
26
Qwen3.8 Max 💡 xhigh
74,2
—
27
DeepSeek V4 Pro 💡 enabled
73,4
—
28
MiniMax M3 💡 enabled
73,0
—
31
Qwen3.7 Max 💡 enabled
72,1
—
33
Qwen3.8 Flash 💡 high
70,2
—
34
Hy4 Preview 💡 high
69,9
—
35
Qwen3.7 Plus 💡 enabled
69,7
—
35
Qwen3.8 27B Q8_0 💡 xhigh** 🏠
69,7
—
37
GLM 5.3 Flash 💡 high
68,7
—
38
GLM 5.2 💡 enabled
64,3
—
39
Seed 2.1 Turbo ↯
64,1
—
40
Inkling 💡 high
63,9
—
42
MiMo V2.5 Pro 💡 enabled
62,0
—
43
Nemotron 3 Ultra 💡 high
61,4
—
46
Mistral Large 4 💡 high
57,7
—
47
Aion 3.0 💡 mandatory
55,5
—
48
Qwen3.6 27B Q8_0 💡 on* 🏠
53,6
—
50
Gemma 4 26B A4B Q8_0 ↯ 🏠
52,5
—
51
Hy3 💡 high
51,0
—
52
Gemma 4 26B A4B Q8_0 💡 on* 🏠
50,5
—
54
DeepSeek V4 Flash 💡 enabled
49,7
—
59
Agnes 3.0 Flash 💡 high
46,4
—
62
Gemma 4 12B Q8_0 💡 on* 🏠
43,6
—
64
MiMo V2.5 💡 enabled
42,3
—
64
Gemma 4 31B Q8_0 💡 on* 🏠
42,3
—
68
MiMo V2.6 Flash 💡 high
37,8
—
69
Qwen3.6 35B A3B Q8_0 💡 on* 🏠
36,9
—
70
Grok 4.6 💡 high
36,8
—
71
Gemma 4 12B Q8_0 ↯ 🏠
35,5
—
72
Gemma 4 31B Q8_0 ↯ 🏠
34,0
—
75
Mistral Medium 3.5 💡 high
32,1
—
81
Qwen3.8 27B Q8_0 ↯ 🏠
23,9
—
83
Nemotron 3.5 Lightning 💡 high
18,0
—
85
Gemma 4 E4B Q8_0 ↯ 🏠
17,7
—
86
Qwen3.6 27B Q8_0 ↯ 🏠
17,6
—
87
Gemma 4 E4B Q8_0 💡 on* 🏠
15,3
—
88
Qwen3.6 35B A3B Q8_0 ↯ 🏠
15,2
—
93
Gemma 4 E2B Q8_0 ↯ 🏠
8,8
—
94
Gemma 4 E2B Q8_0 💡 on* 🏠
8,5
—
97
Granite 4.2 30B Q8_0 💡 full 🏠
7,2
—
103
Nemotron 3 Nano Omni 30B A3B Q8_0 💡 on* 🏠
3,0
—
105
MiniMax M3.1 Flash 💡 high
2,4
—
106
Granite 4.2 8B Q8_0 💡 full 🏠
1,4
—
Aucun résultat publié pour cette sélection
Un modèle apparaît après sa première évaluation individuelle publiée ; son score de classement apparaît après son premier duel admissible.
107 modèles comparés · 105 568 verdicts IA publiés
Méthode : modèle de Bradley–Terry régularisé. Le score des juges IA détermine le rang ; le score humain est indépendant et reste secondaire tant que les votes de la communauté sont peu nombreux. Un score de 50 correspond à une chance estimée sur deux de battre le modèle moyen dans cette langue et cette catégorie.
Résultats des duels directs
Chaque cellule indique la part des points possibles obtenue par le modèle de la ligne face au modèle de la colonne : une victoire vaut 100 %, une égalité 50 %, une défaite 0 %. Cette matrice n’utilise que les protocoles d’évaluation compatibles avec le classement principal.
Matrice orientée des points obtenus en duel direct. Au-dessus de 50 %, l’avantage va au modèle de la ligne ; en dessous, au modèle de la colonne.
0 %100 %
💡 signale un modèle avec raisonnement, ↯ un modèle sans raisonnement. 🏠 signale un modèle exécuté localement sur la machine de l’auteur de ce site.« on* » indique que le raisonnement est activé ou désactivé (modèles locaux sans niveaux intermédiaires) : le réglage fin demandé n’est pas pris en charge par le fichier local et retombe sur le mode activé par défaut. Sur les modèles locaux à raisonnement réglable (Qwen3.8, Muse Glimmer, Granite 4.2, Nemotron 3 Super, K2 Horizon, Ling 3.0 Flash), le niveau affiché (xhigh**, high, full) est le niveau par défaut du modèle : le réglage fin demandé n’est pas pris en charge par le fichier local, qui retombe sur son comportement par défaut.
Afficher sous forme de tableau
Points obtenus en duel direct par paire de modèles
Modèle
Couverture des duels publiés
Chaque cellule indique combien de duels jugés par IA et publiés, tous protocoles confondus, comparent les deux modèles pour cette langue et cette catégorie. Les modèles des deux axes sont des candidats ; la matrice n’indique pas quel juge a produit chaque verdict.
Matrice symétrique du nombre de duels publiés. La diagonale vaut zéro : un modèle n’est pas comparé à lui-même.
0
💡 signale un modèle avec raisonnement, ↯ un modèle sans raisonnement. 🏠 signale un modèle exécuté localement sur la machine de l’auteur de ce site.« on* » indique que le raisonnement est activé ou désactivé (modèles locaux sans niveaux intermédiaires) : le réglage fin demandé n’est pas pris en charge par le fichier local et retombe sur le mode activé par défaut. Sur les modèles locaux à raisonnement réglable (Qwen3.8, Muse Glimmer, Granite 4.2, Nemotron 3 Super, K2 Horizon, Ling 3.0 Flash), le niveau affiché (xhigh**, high, full) est le niveau par défaut du modèle : le réglage fin demandé n’est pas pris en charge par le fichier local, qui retombe sur son comportement par défaut.
Afficher sous forme de tableau
Nombre de duels publiés par paire de modèles
Modèle
Lancez un duel
Quel modèle écrit le meilleur texte ? Jugez cette paire anonyme et contribuez au classement humain. Pendant le duel, le nom des modèles reste masqué. Il n’est révélé qu’après votre choix.
Le classement a un vainqueur ; vos textes n’en ont pas un seul. Au 20 septembre, sur les seuls duels d’un type de texte, Claude Fable 5 dominait la fiction et la dissertation, Claude Opus 5 les lettres personnelles, Claude Fable 5.1 les lettres de motivation. Un guide simple, tâche par tâche, avec le meilleur fichier à faire tourner chez soi pour chacune.
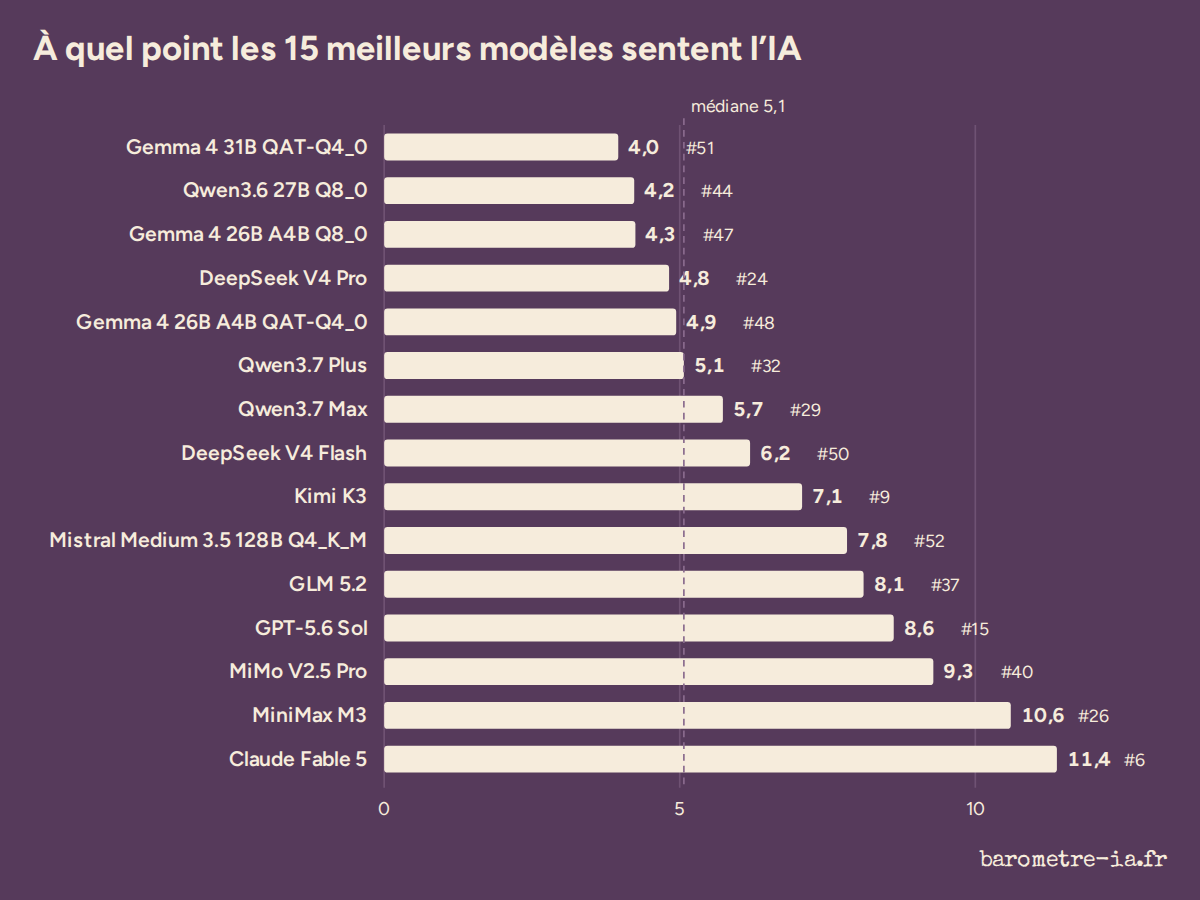
Nous avons compté, dans 3 574 textes classés en français, les marques que les lecteurs appellent « de l’IA » : tirets cadratins, formules toutes faites, « non pas X mais Y », listes de trois, calques de l’anglais. Claude Fable 5, alors troisième du classement, en a le plus ; les modèles les plus sobres sont des fichiers locaux en milieu de tableau. Et « véritable » apparaît 494 fois.
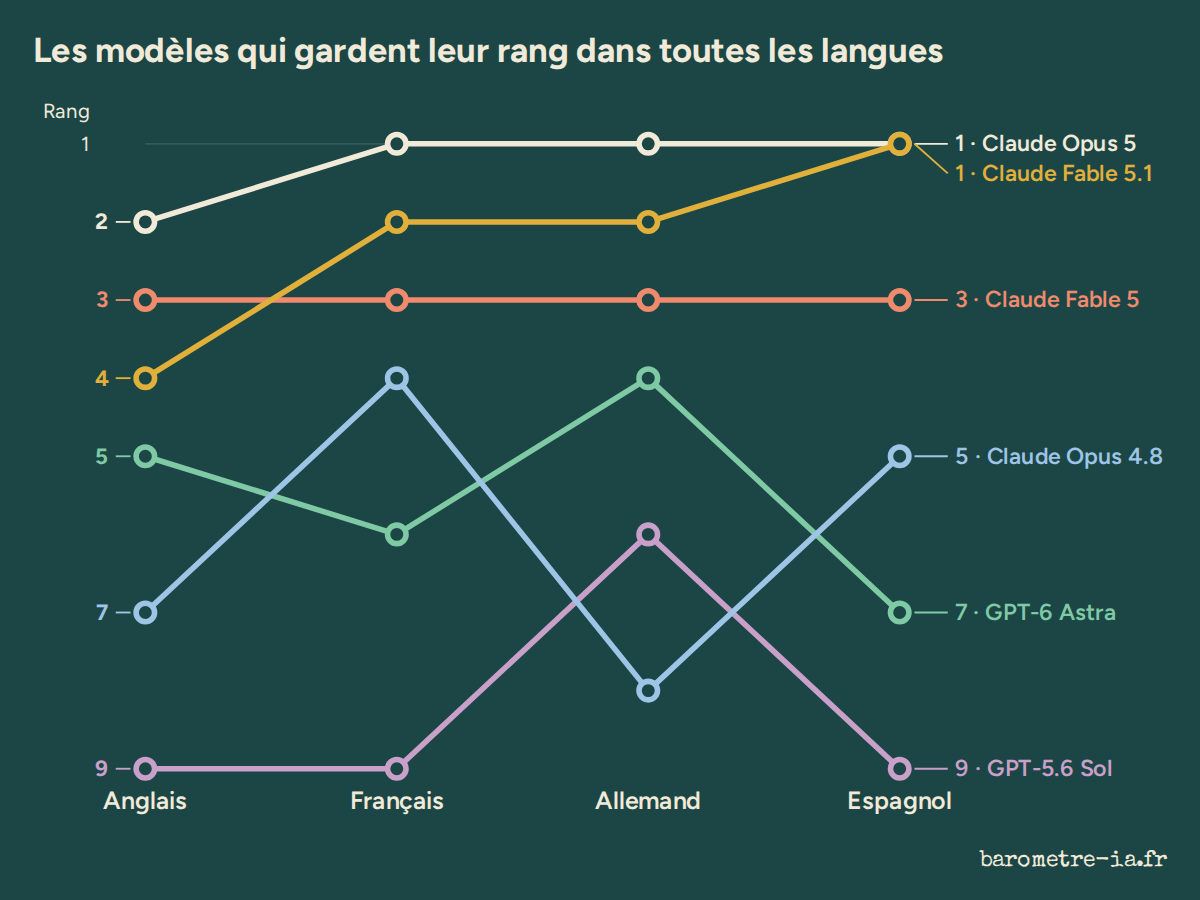
Quatre-vingt-onze modèles sont classés en anglais, en français, en allemand et en espagnol selon le même protocole. Au 19 septembre, Claude Fable 5 était troisième dans les quatre langues, Claude Opus 5 premier en français. Plus bas, Grok 4.6 était 25e en anglais et 60e en français, et Qwen3.8 27B le meilleur modèle local en français mais l’un des plus faibles en allemand.
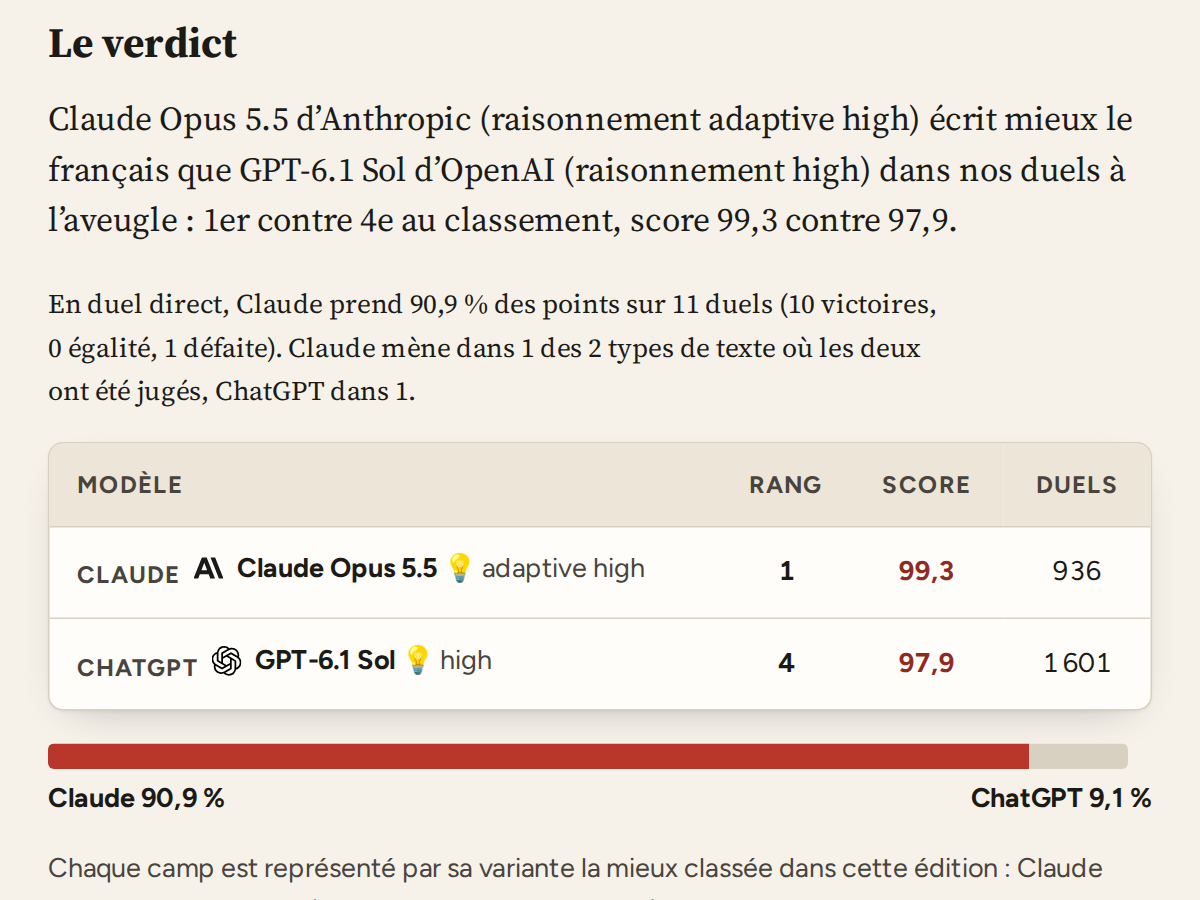
Les deux assistants les plus demandés, jugés sur les mêmes consignes en français dans des duels à l’aveugle : lequel écrit le mieux, de combien, et pour quels types de texte. Mis à jour à chaque export du classement.
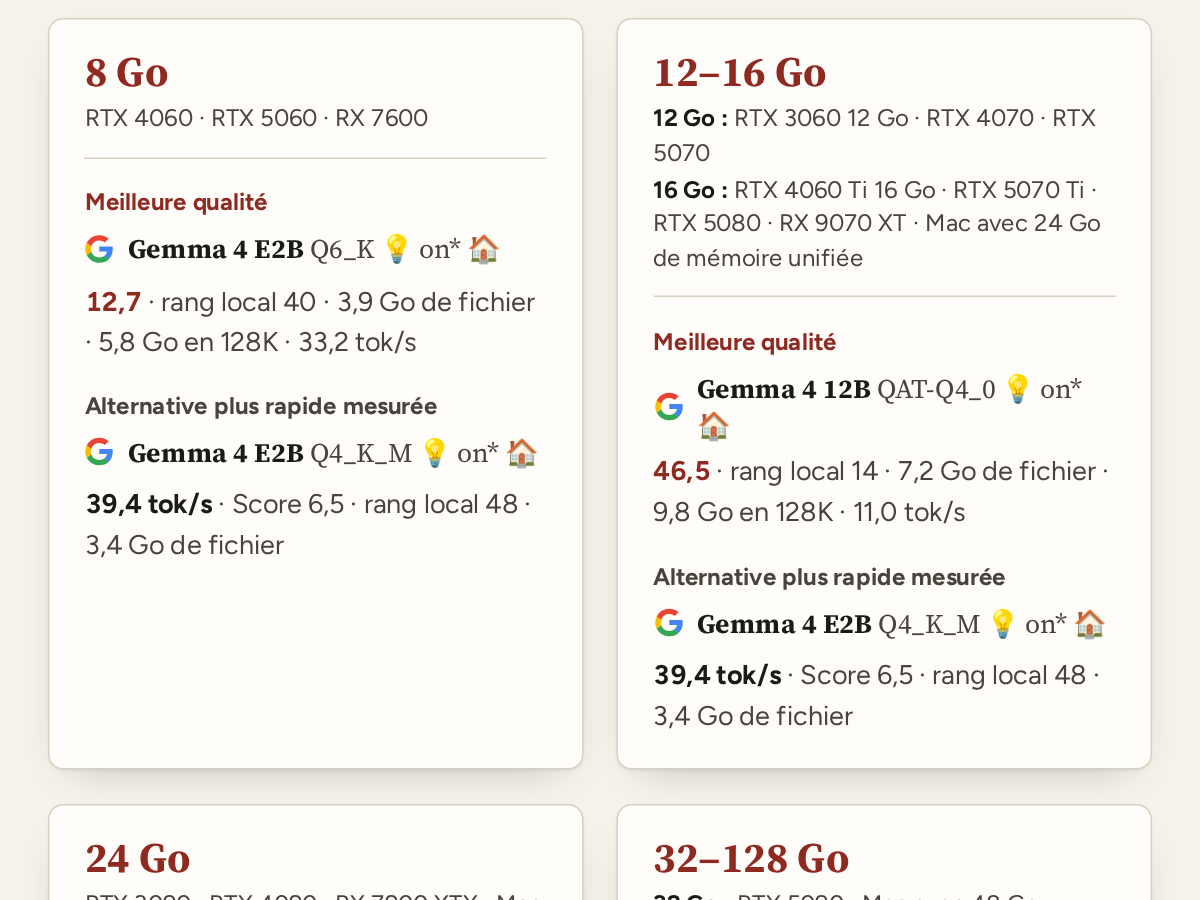
Le classement vivant des modèles à poids ouverts pour écrire en français, la mémoire que demande chaque fichier et ce qui tient dans 16, 24, 32 ou 128 Go.